以前训练模型,都是ssh到实验室服务器,上传代码或者直接使用vscode到remote编写、修正代码并开始训练,隔段时间去看一下进度如何。偷懒是第一生产力,后来我发现,其实这个任务可以托管给Codex,只不过在可视化、流程完整性上还是有所欠缺,因此,本尝试一套从文献召回到代码撰写与模型训练,再到训练实时监控与结果评估的 Agent 托管流程,取名为 AutoResearch Hub。
前言
AutoResearch Hub 是面向科研项目的自主研究控制平台,我们希望它把研究计划、领域文献、代码工作区、模型 Agent、GPU 训练任务和实验结果统一到一个可恢复、可审计、可远程控制的执行闭环中,并实现在明确的项目边界、资源预算和审批机制下,使 Agent 能够完成文献检索、方案可行性分析、代码实现、训练提交、指标跟踪、结果比较、绘图和研究总结。
平台以 Karpathy Autoresearch 的“小步修改—固定预算实验—客观指标评估—保留或回退”思想作为实验协议参考,以 Pi 作为 Linux 侧默认 coding-agent harness,并在其外部增加身份认证、项目隔离、文献 RAG、GPU 任务管理、持久工作流、训练心跳、MCP 接入、审计和可观测性。针对上面的需求,我们列举以下工程目标:
- 接受研究者提供的详细研究方向、研究计划和技术路线,并将其固化为项目上下文;
- 支持批量领域文献导入、结构化解析、合理切块、混合检索和原文追溯;
- 允许本地 Linux Agent 或外部 Agent 在项目范围内编写代码、读取数据和发起受控训练;
- 将训练从 Agent 对话生命周期中解耦,支持实时日志、结构化指标、GPU 状态和低成本心跳;
- 通过 REST 与项目级 MCP 暴露统一控制面,使 Codex 等外部 Agent 能进入指定项目工作;
- 对用户、项目、文献、会话、模型配置和训练任务实施权限隔离;
- 保留审计记录和研究产物,使实验过程可检查、可复现、可恢复。
AutoResearch Hub 的总体架构如下图所示:
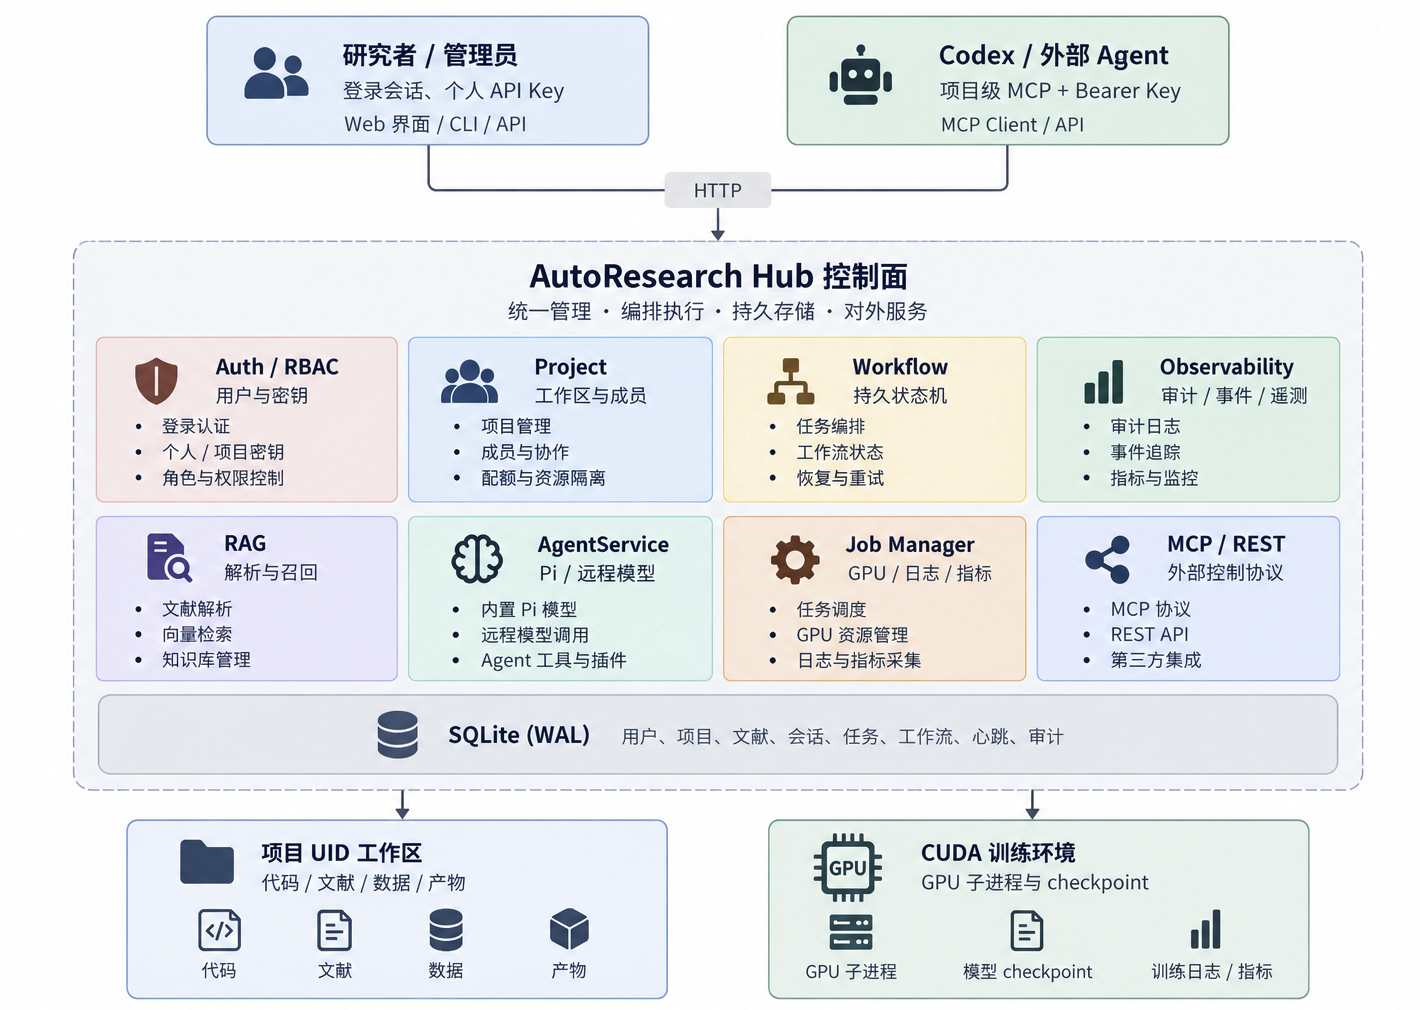
图1:AutoResearch Hub 总体架构
Hybrid RAG
在文献召回方面,项目采用主流的 Hybrid RAG 模式。具体流程包括解析切块,Embedding、Agent 调用混合召回,查询时并行执行两条召回链路:
查询时并行执行两条召回链路:
- Lexical:SQLite FTS5/BM25,适合术语、缩写、方法名、数据集名称和精确表达;
- Dense:SentenceTransformers 或 OpenAI 兼容 Embedding 的余弦相似度,适合语义改写和跨语言表达。
两路候选通过 Reciprocal Rank Fusion(RRF)融合。简化表达为:
其中 表示各召回器, 是抑制头部排名差异的常数。该策略不要求 BM25 分数与向量相似度具有相同量纲,适合工程上稳定融合。
Embedding 后端支持:
- 本地 SentenceTransformers,设备可选 CPU 或指定 GPU;
- OpenAI 兼容
/embeddings第三方服务; - 不同项目或导入批次选择不同后端。
Agent 原生工具包括 rag_search、list_documents 和 read_chunk。召回结果携带 document ID、chunk ID、文件名、页码和章节。Agent 可以先广泛召回,再读取命中段落精查;用户也能依据同一标识查看段落和全文。因此,最终结论可以从回答回溯到具体原文。
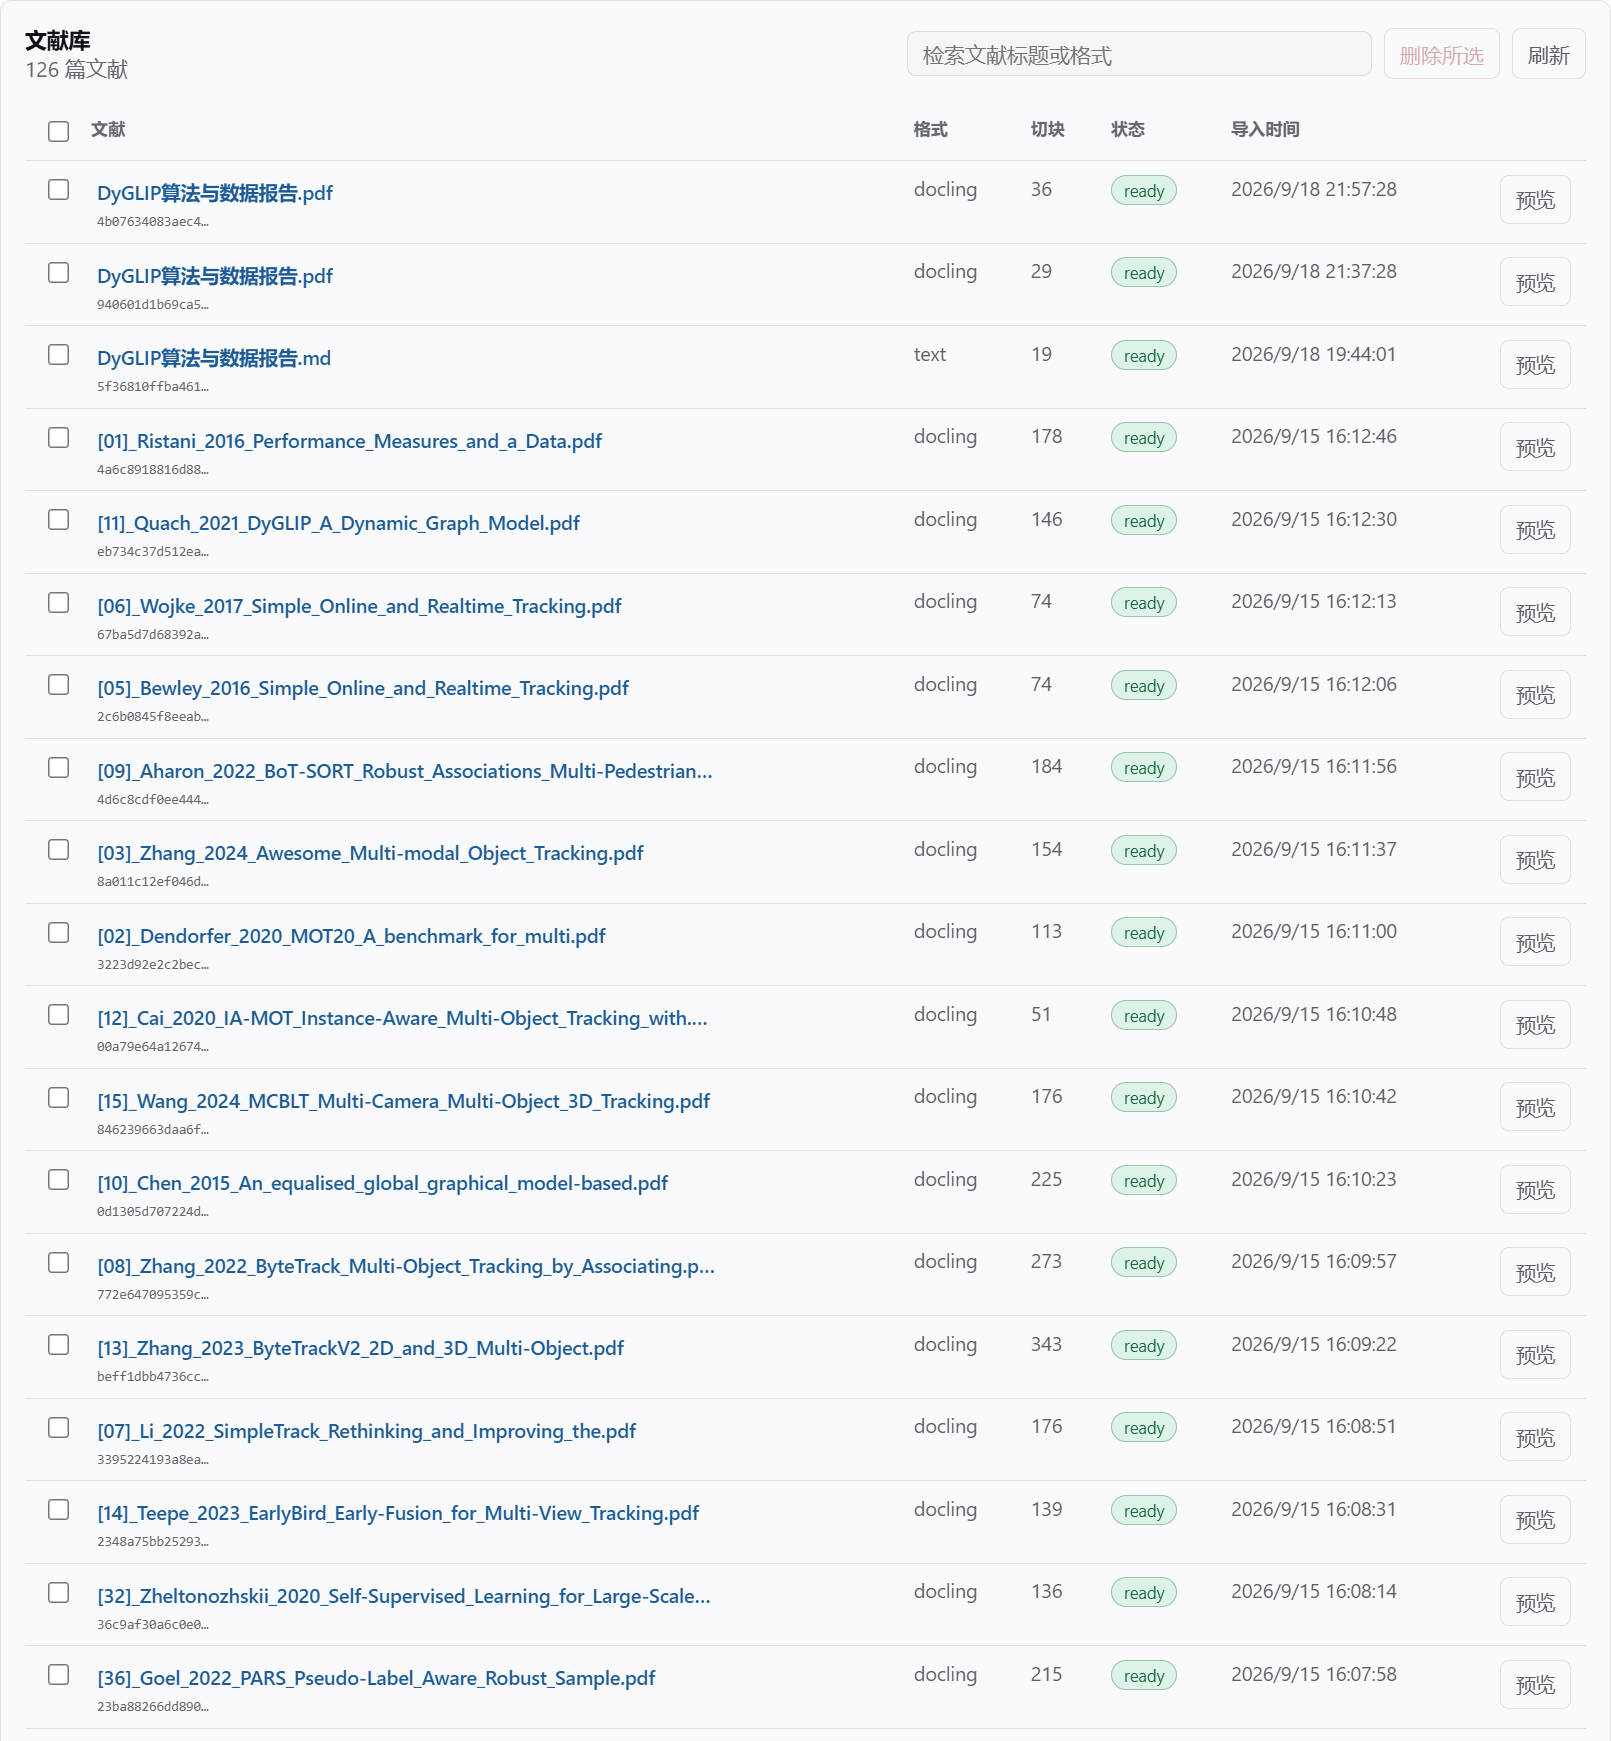
图2:文献库管理与原文追溯
此外,系统还支持的基本的文件系统,支持预览、编辑、上传与下载。
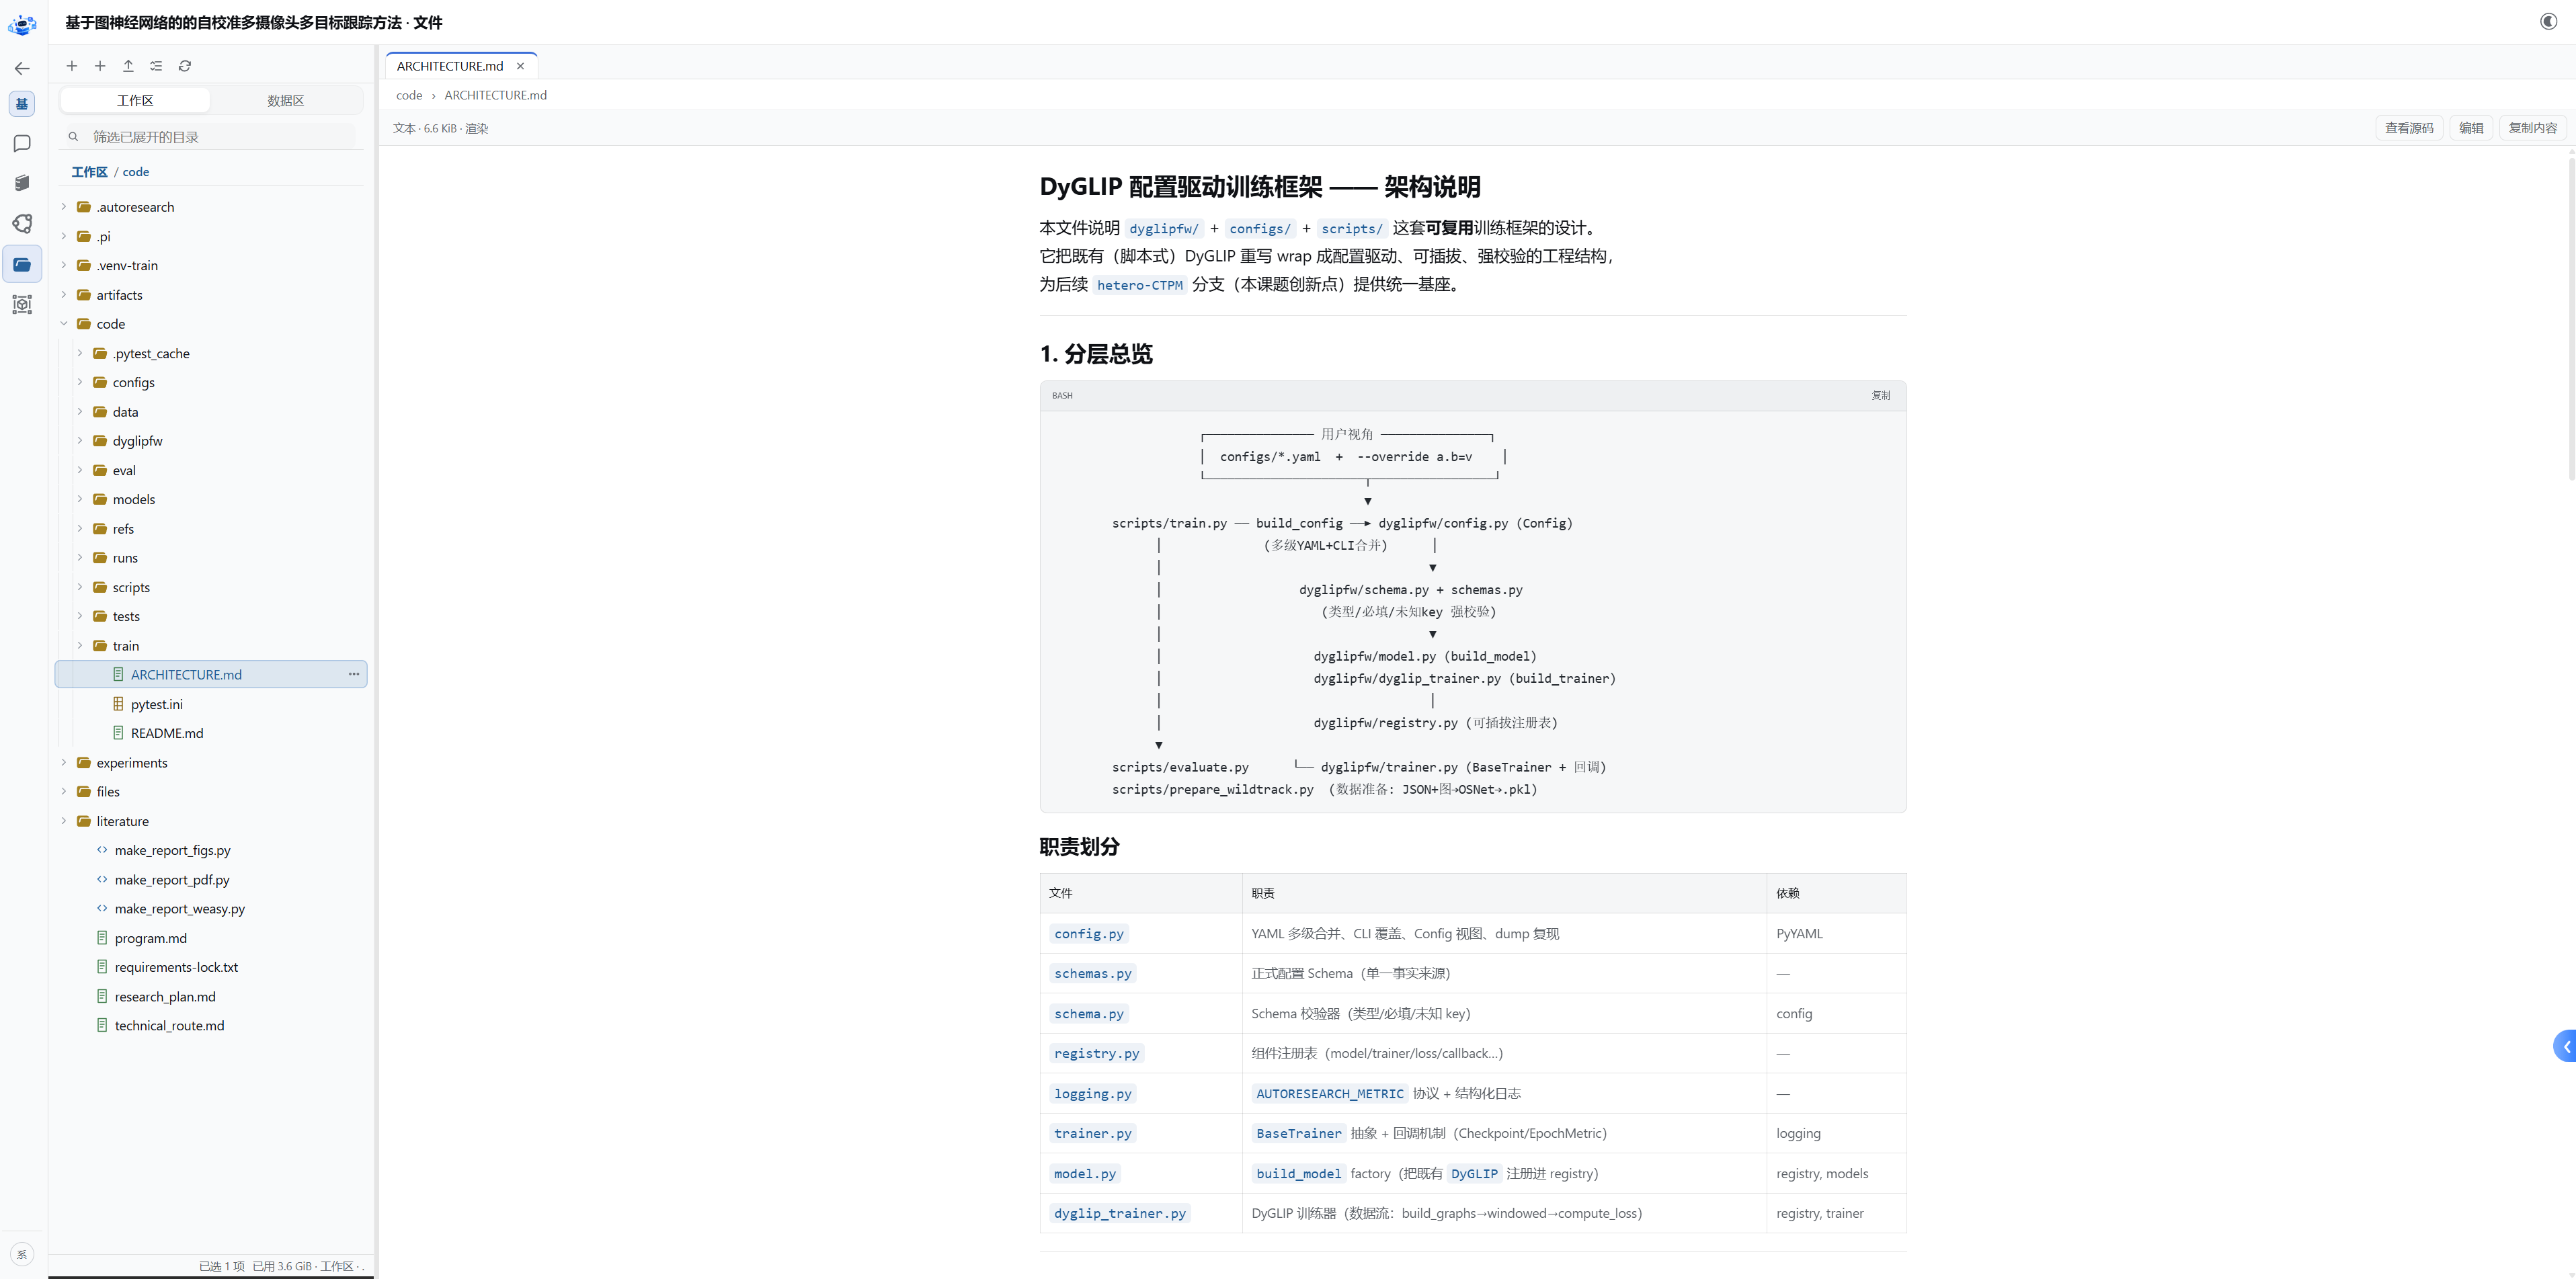
图3:项目文件系统
Agent 与工作流
我们基于 Pi 的可拓展体系,初步挂载了一下几个工具:
rag_search,在当前项目文献中执行混合检索list_documents,列出当前项目可访问文献read_chunk,根据 document/chunk ID 读取原文证据platform_status,检查 RAG、工作区和训练环境状态plot_chart,在项目训练环境中生成科研图像并保存到artifacts/figures/run_training_job,通过受控 Job Manager 提交训练并跟踪 GPU、指标和日志
同时,也挂载了面向文献综述、科研写作、深度学习实验和 Autoresearch 流程等多个Skill。
工作流方面,默认 Autoresearch 工作流阶段为:
.autoresearch/job.json
各阶段含义如下:
| 阶段 | 主要产出 |
|---|---|
| plan | 问题拆解、假设、数据需求、评价指标和资源估计 |
| retrieve | 多查询 RAG 证据包,带页码和 chunk 标识 |
| feasibility | 结构化可行性报告、风险、依赖与停止条件 |
| approval | 人工 approve / revise / reject 决策 |
| implement | 代码、配置、实验入口和 .autoresearch/job.json |
| train | 经 Job Manager 校验后运行 GPU 任务 |
| evaluate | 读取指标、日志和产物,执行评价协议 |
| review | 复核结论、失败原因和证据充分性 |
| finalize | 汇总报告、代码与实验产物 |
论文复现采用更细的阶段:
该流程首先从论文中抽取数据集、划分方式、指标、关键超参数和目标结果,再执行实现与训练。compare 阶段把复现实验值与论文报告值并列,visualize 阶段生成对比图,最终报告需要区分“完全复现”“趋势一致”“部分复现”和“不可比”。
GPU 训练控制与实时监控
Agent 不直接以后台 Shell 启动训练。implement 阶段必须生成 .autoresearch/job.json,例如:
1 | { |
系统接收到信息并校验通过后开始训练,在训练任务的生命周期中,任务状态包括 queued、running、succeeded、failed 和 cancelled。调度器按照并发上限和 GPU 可用性领取任务,启动独立进程组并降权到项目 UID。支持:
- GPU 排队与租约;
- 最大运行时长;
- 主动取消;
- 超时后进程组清理;
- stdout/stderr 持久日志;
- 软删除、重命名和星标;
- 项目、工作流和创建人关联。
训练脚本通过标准输出发送一行一个 JSON 的结构化指标:
1 | AUTORESEARCH_METRIC {"step":120,"loss":0.314,"val_loss":0.351,"accuracy":0.91,"lr":0.0003} |
通过这个流程,我们得以在对话中实时检测训练过程数据。
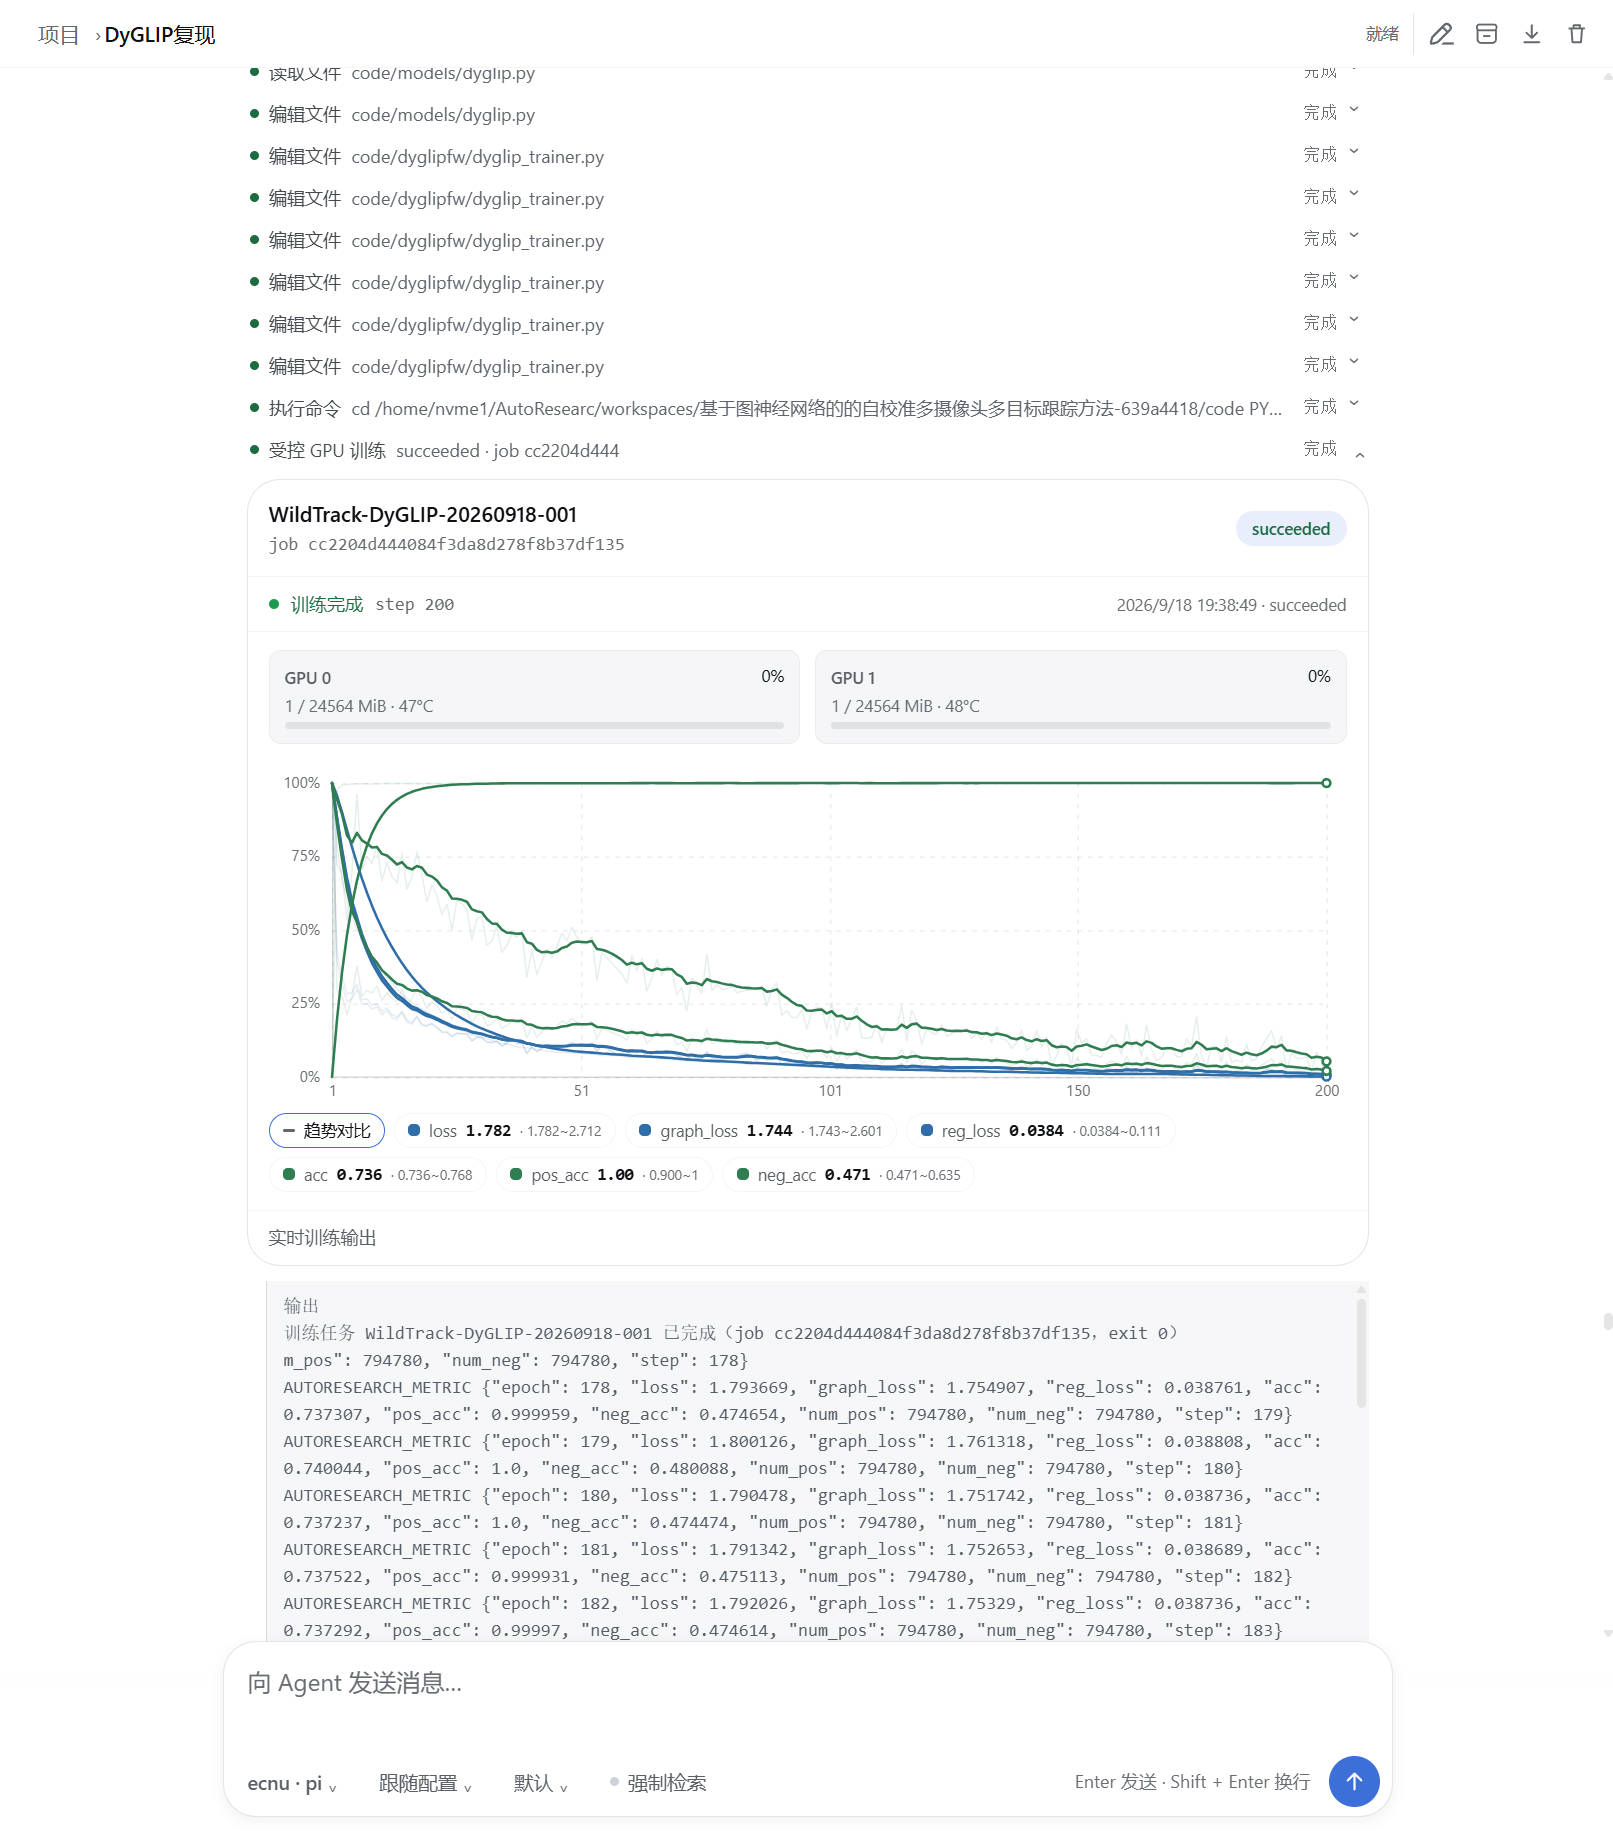
图4:对话中的训练过程实时监控
由于我们的模型训练往往是一个长程任务,我们无法期望其在一个loop中完成,Agent 需要等待大量时间,因此,系统采用心跳机制,完成下面的操作:
- 读取增量日志和新增指标;
- 查询进程状态和 GPU 遥测;
- 更新最后 step、日志 offset、最新指标和最后进展时间;
- 判断 warming_up、watching、attention_required 或 completed;
- 将有界心跳记录写入
job_heartbeats; - 仅在停滞、异常、失败或完成时唤醒原 Agent 会话复核。
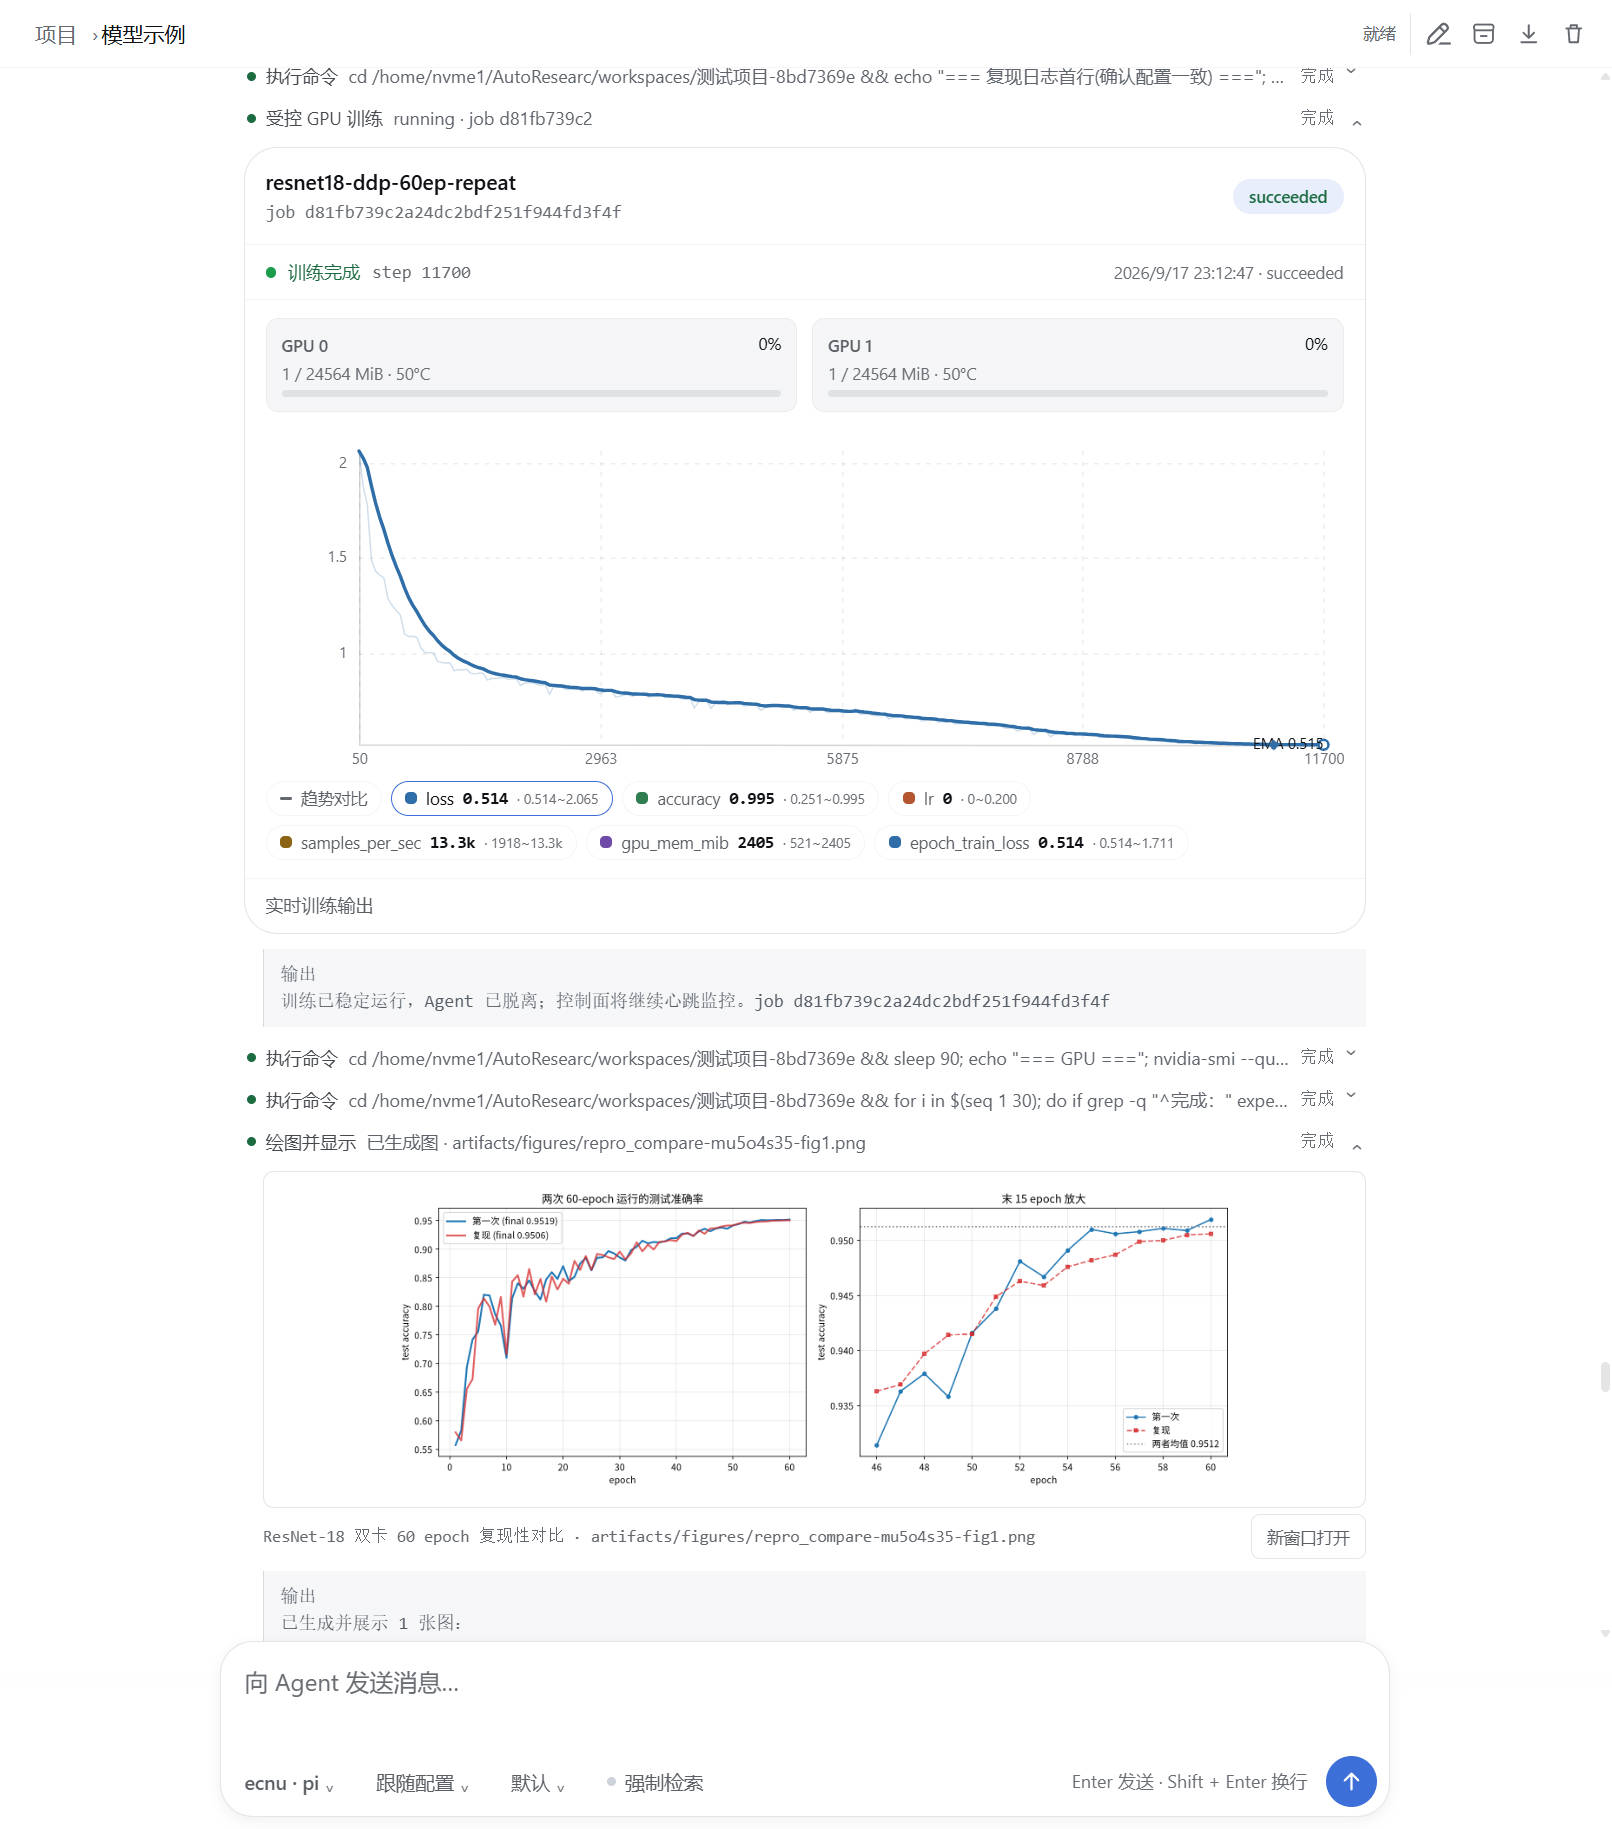
图5:训练完成与过程分析
同时,系统也支持查看训练队列中的历史数据,如下图所示。
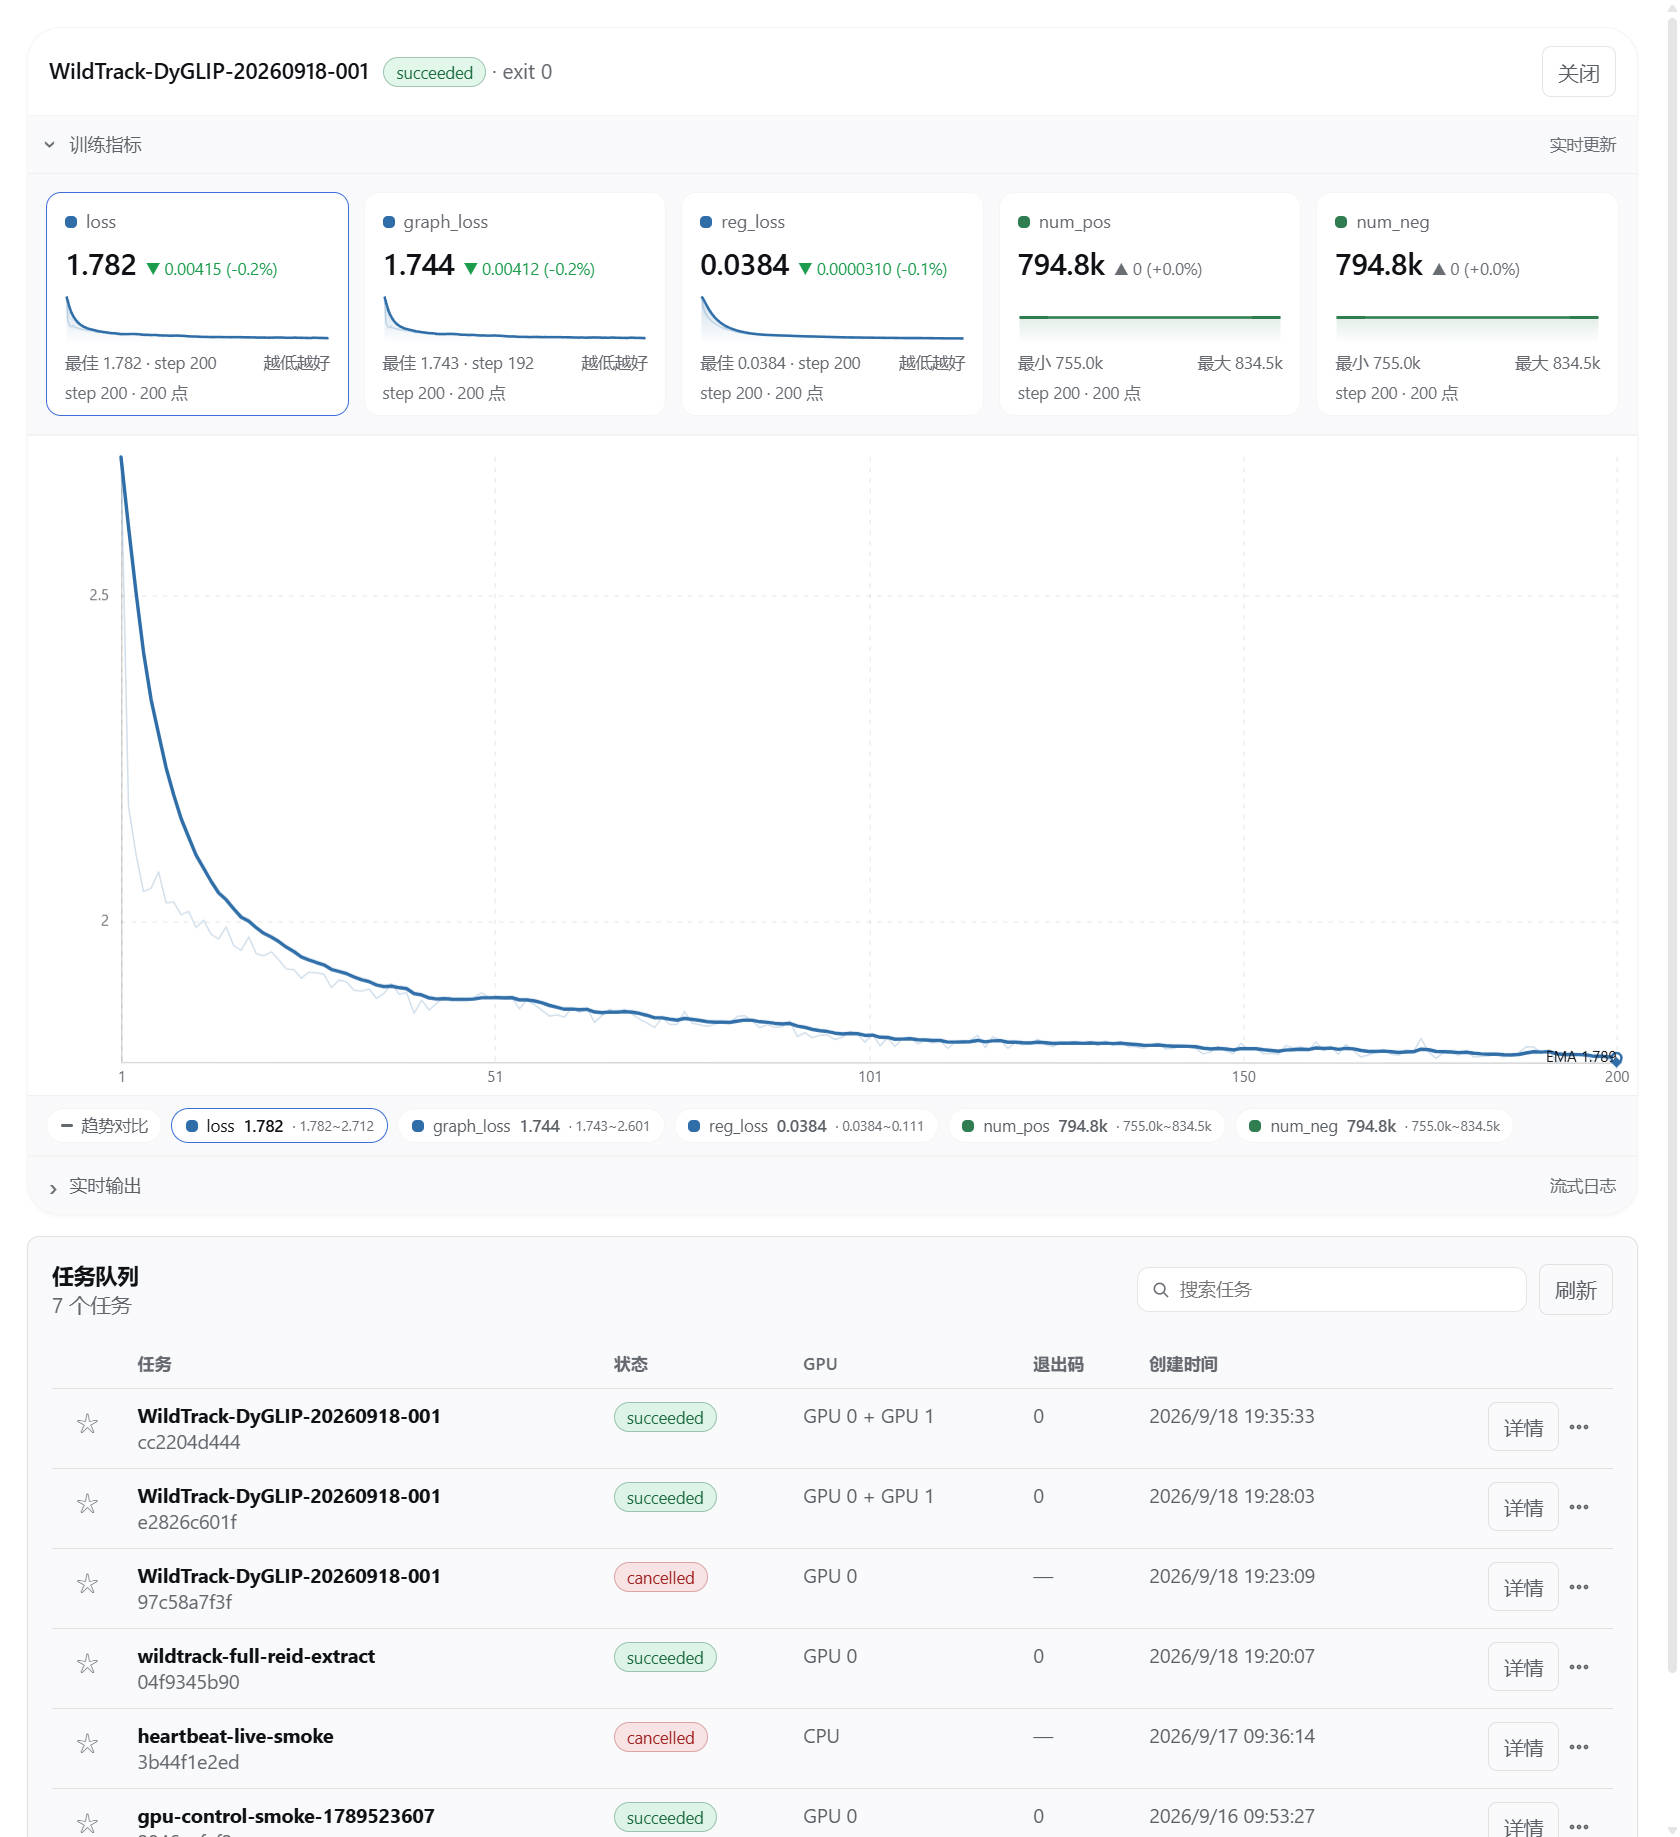
图6:训练队列历史数据
MCP 与外部 Agent 接入
系统通过 MCP Streamable HTTP 暴露研究控制能力。项目级入口形如:
1 | http://192.168.**.**:*****/mcp/?project_id=<PROJECT_ID> |
服务端根据 URL 中的项目 ID 建立强制作用域,调用者即使在参数中传入其他项目 ID 也会被拒绝。MCP 使用 Bearer API Key 认证,不依赖浏览器登录态。
主要 MCP 工具包括:
| 工具 | 用途 |
|---|---|
system_status |
获取项目工作区、RAG 和任务状态 |
list_jobs / get_job |
查询项目训练任务 |
submit_job / cancel_job |
提交或取消受控训练 |
get_job_logs / get_job_metrics |
读取实时日志和指标 |
search_knowledge |
查询项目私有知识库 |
list_projects / get_project_context |
获取项目与研究上下文 |
list_workflows / get_workflow |
查询工作流进度 |
approve_workflow |
执行可行性审批 |
list_ingestion_batches |
查看文献导入状态 |
update_workflow_progress |
外部可信 Agent 回写进度 |
create_agent_session / send_agent_message |
操作持久 Agent 会话 |
Codex 等外部 Agent 必须通过 submit_job 启动训练,而不是在自身连接中创建不可观测后台进程。只要任务由该接口提交,训练页面就能看到同一个 job 的实时日志、GPU 状态、指标和心跳。
测试
基于上述的架构,我简单测试了一篇文章的复线。Agent实现了召回文章、分析内容、下载数据、撰写代码、调用gpu训练、分析数据的完整闭环,生产报告如下:
图7:复现报告 第 1 页(封面与摘要)
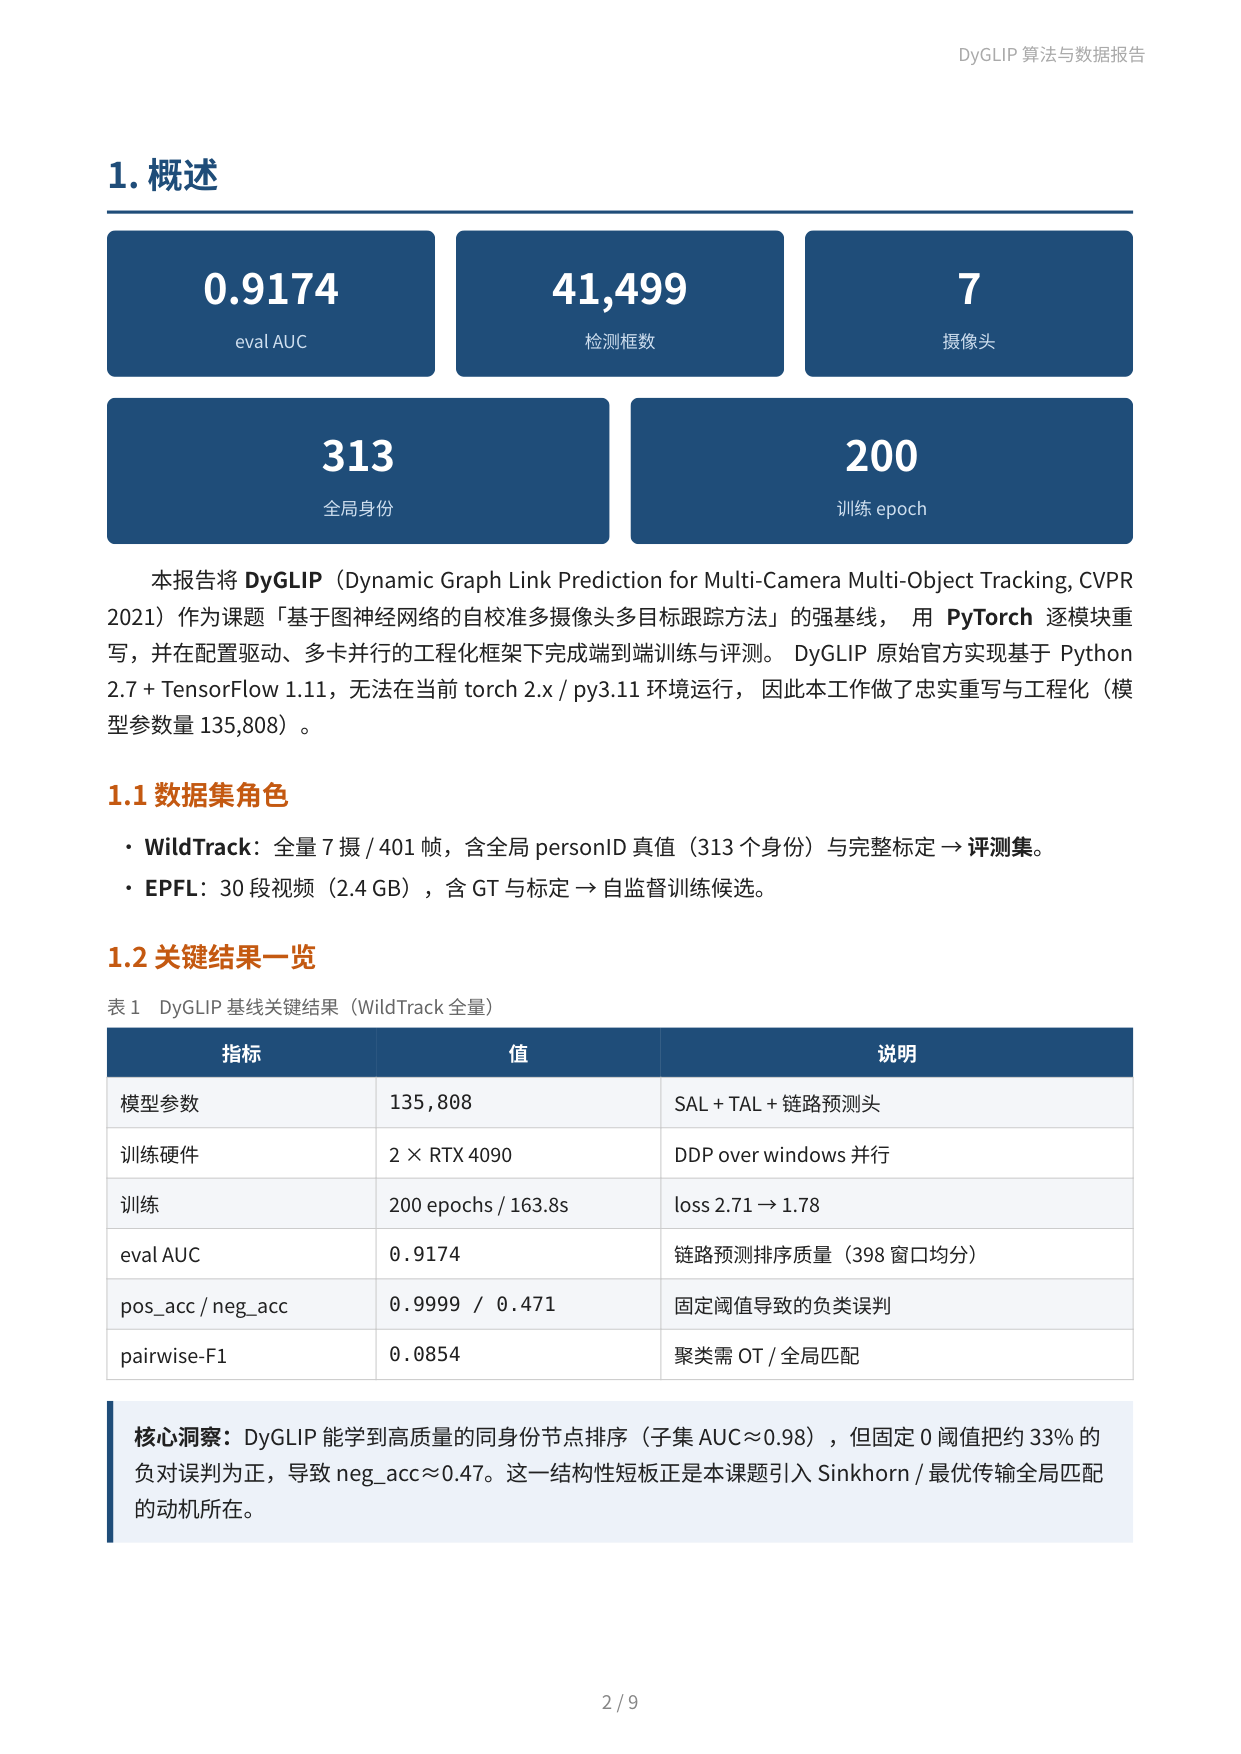
图8:复现报告 第 2 页(概述与关键指标)
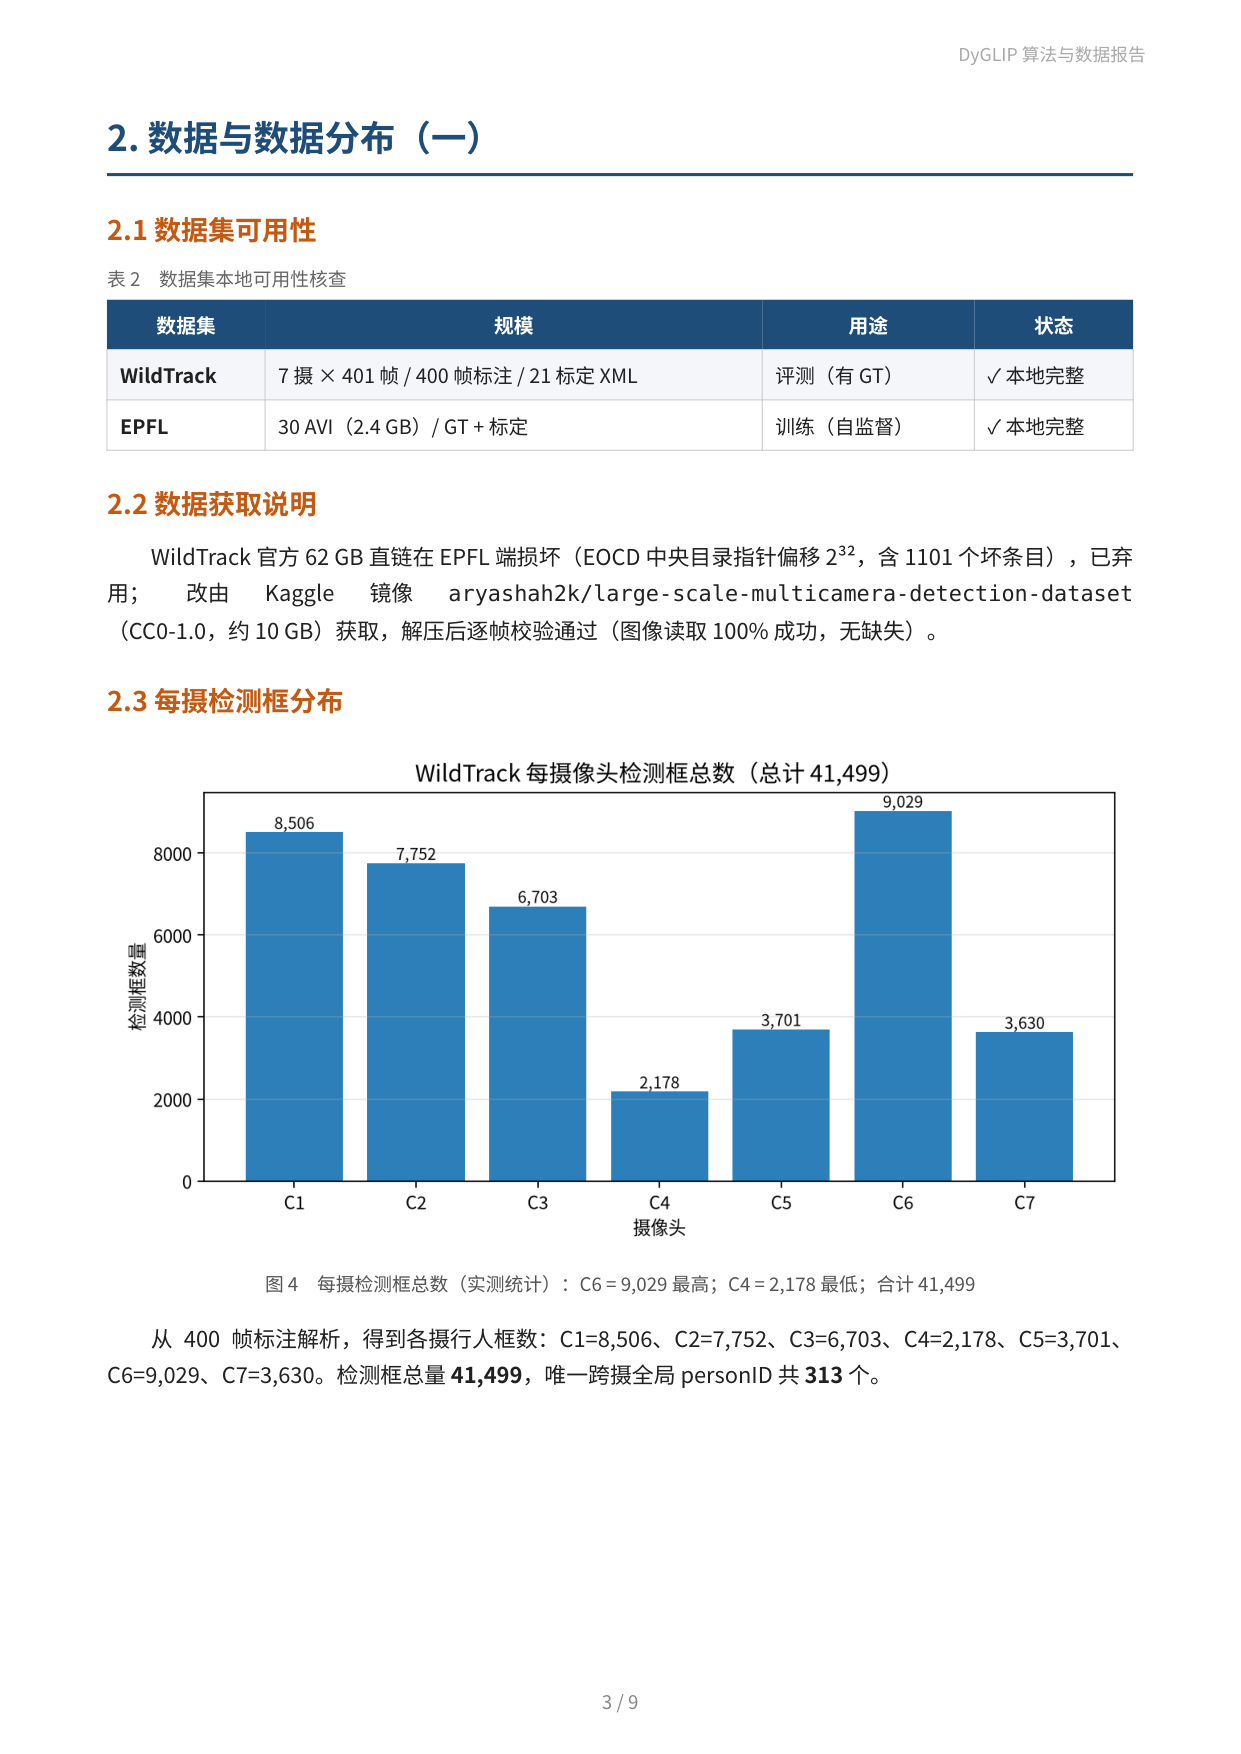
图9:复现报告 第 3 页(数据与数据分布)
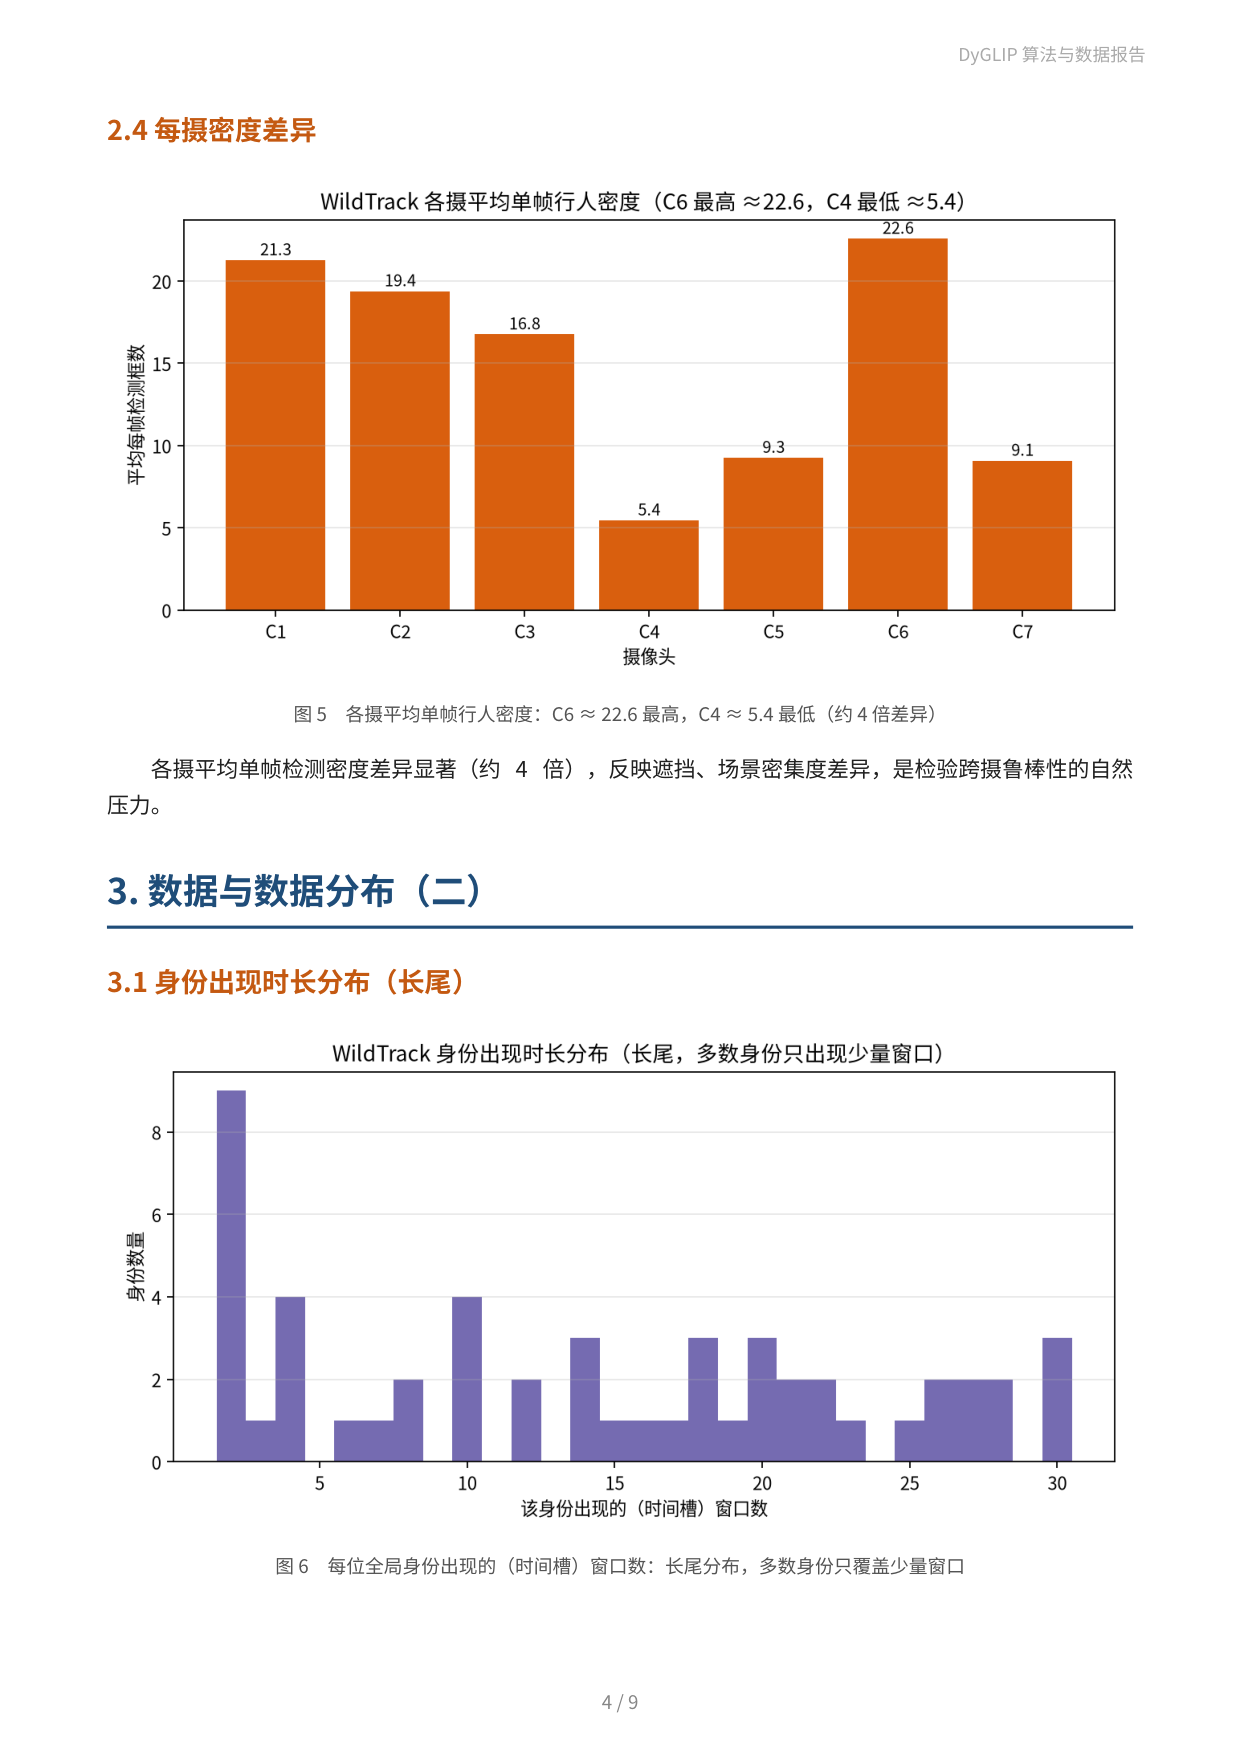
图10:复现报告 第 4 页(每摄密度差异)
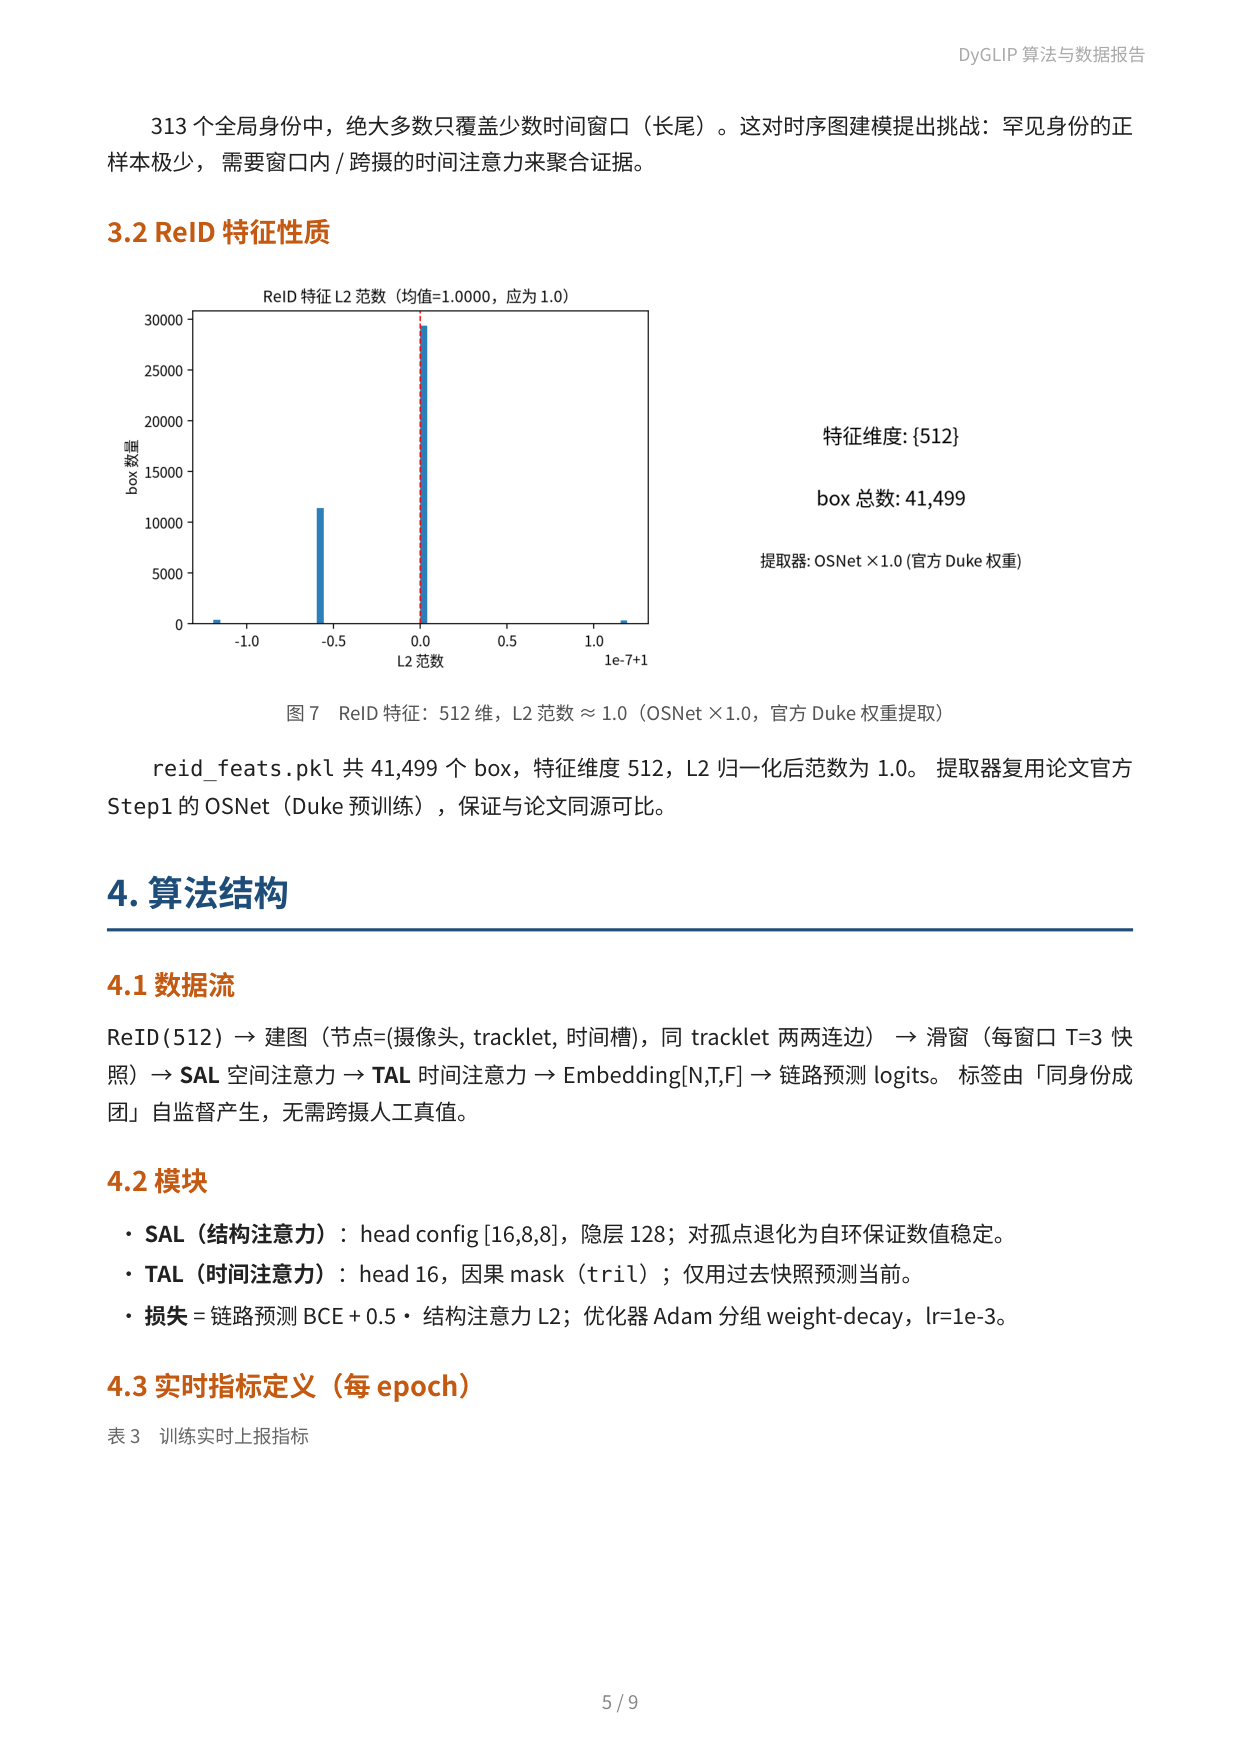
图11:复现报告 第 5 页(身份长尾与 ReID 特征)
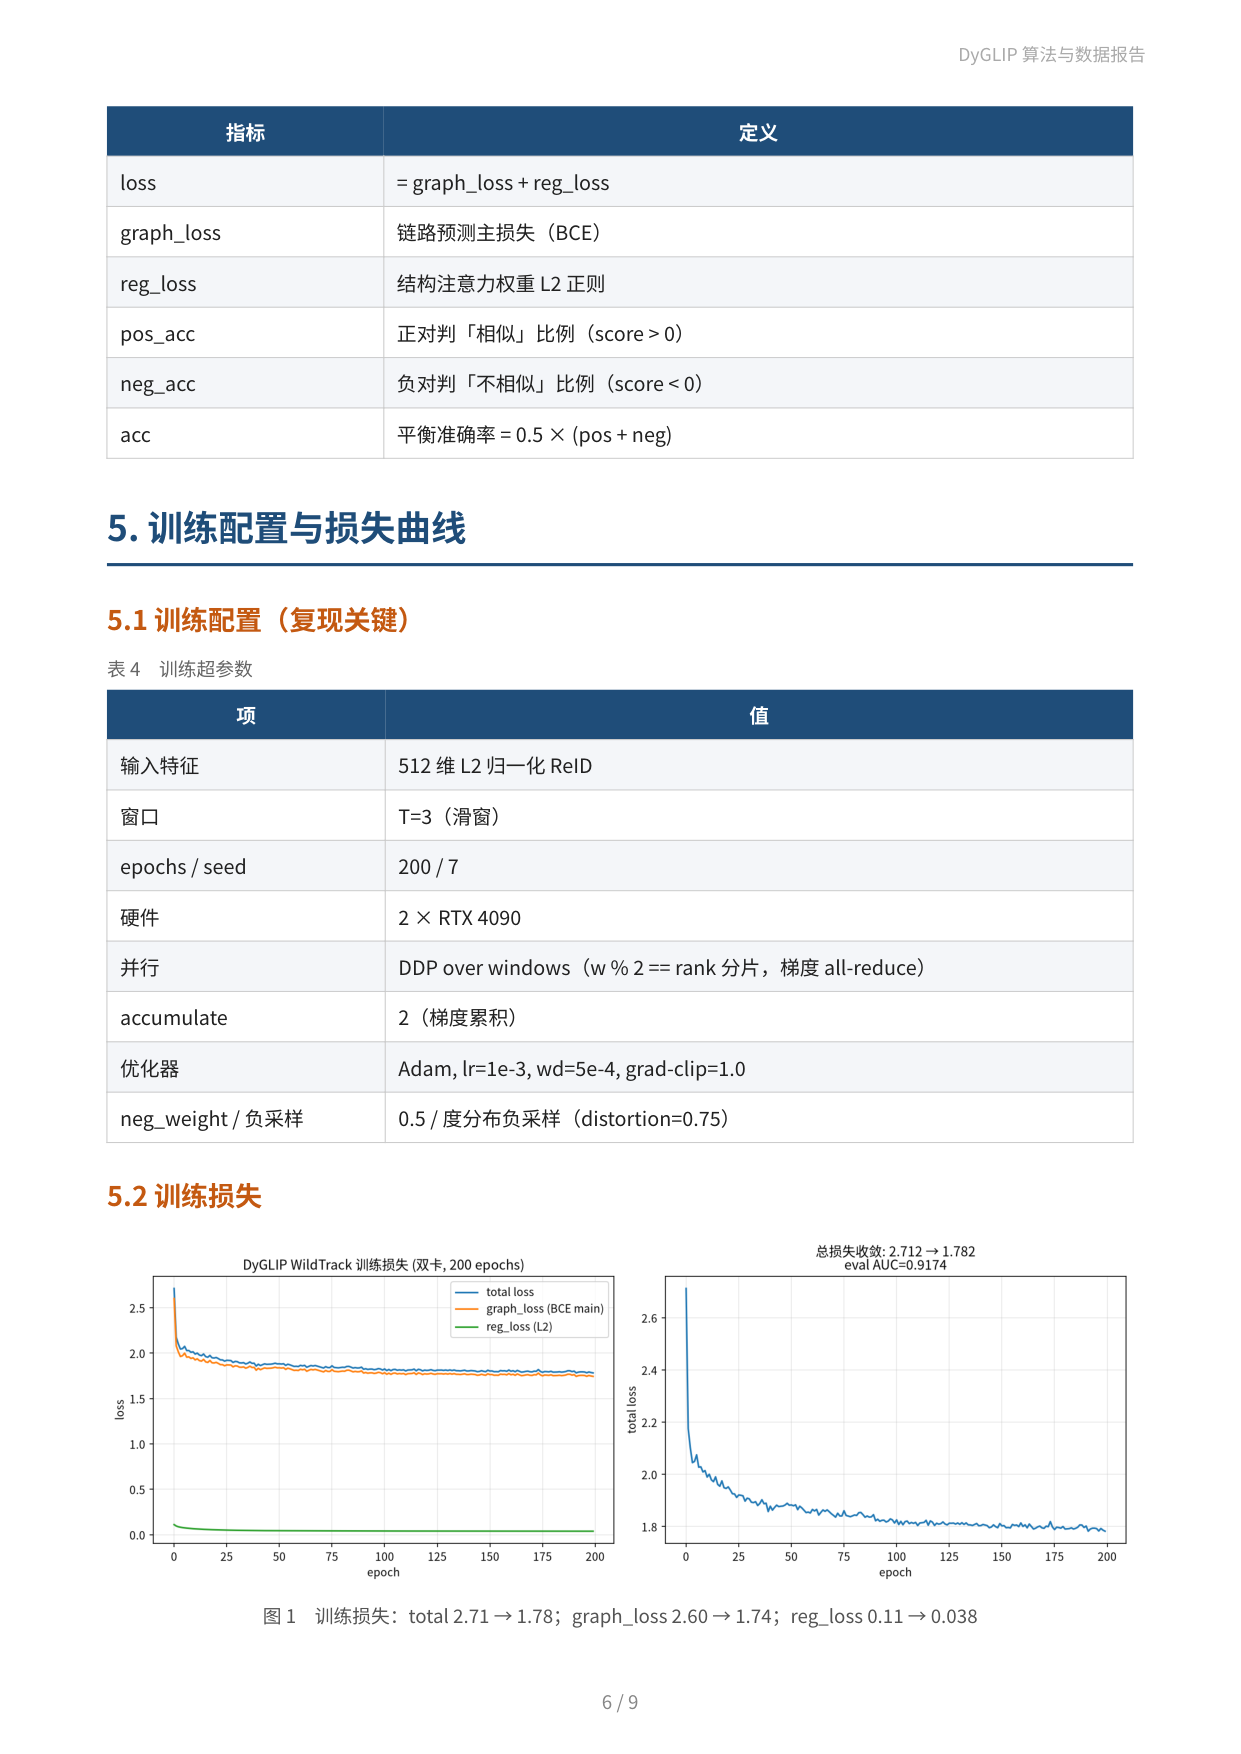
图12:复现报告 第 6 页(指标定义)
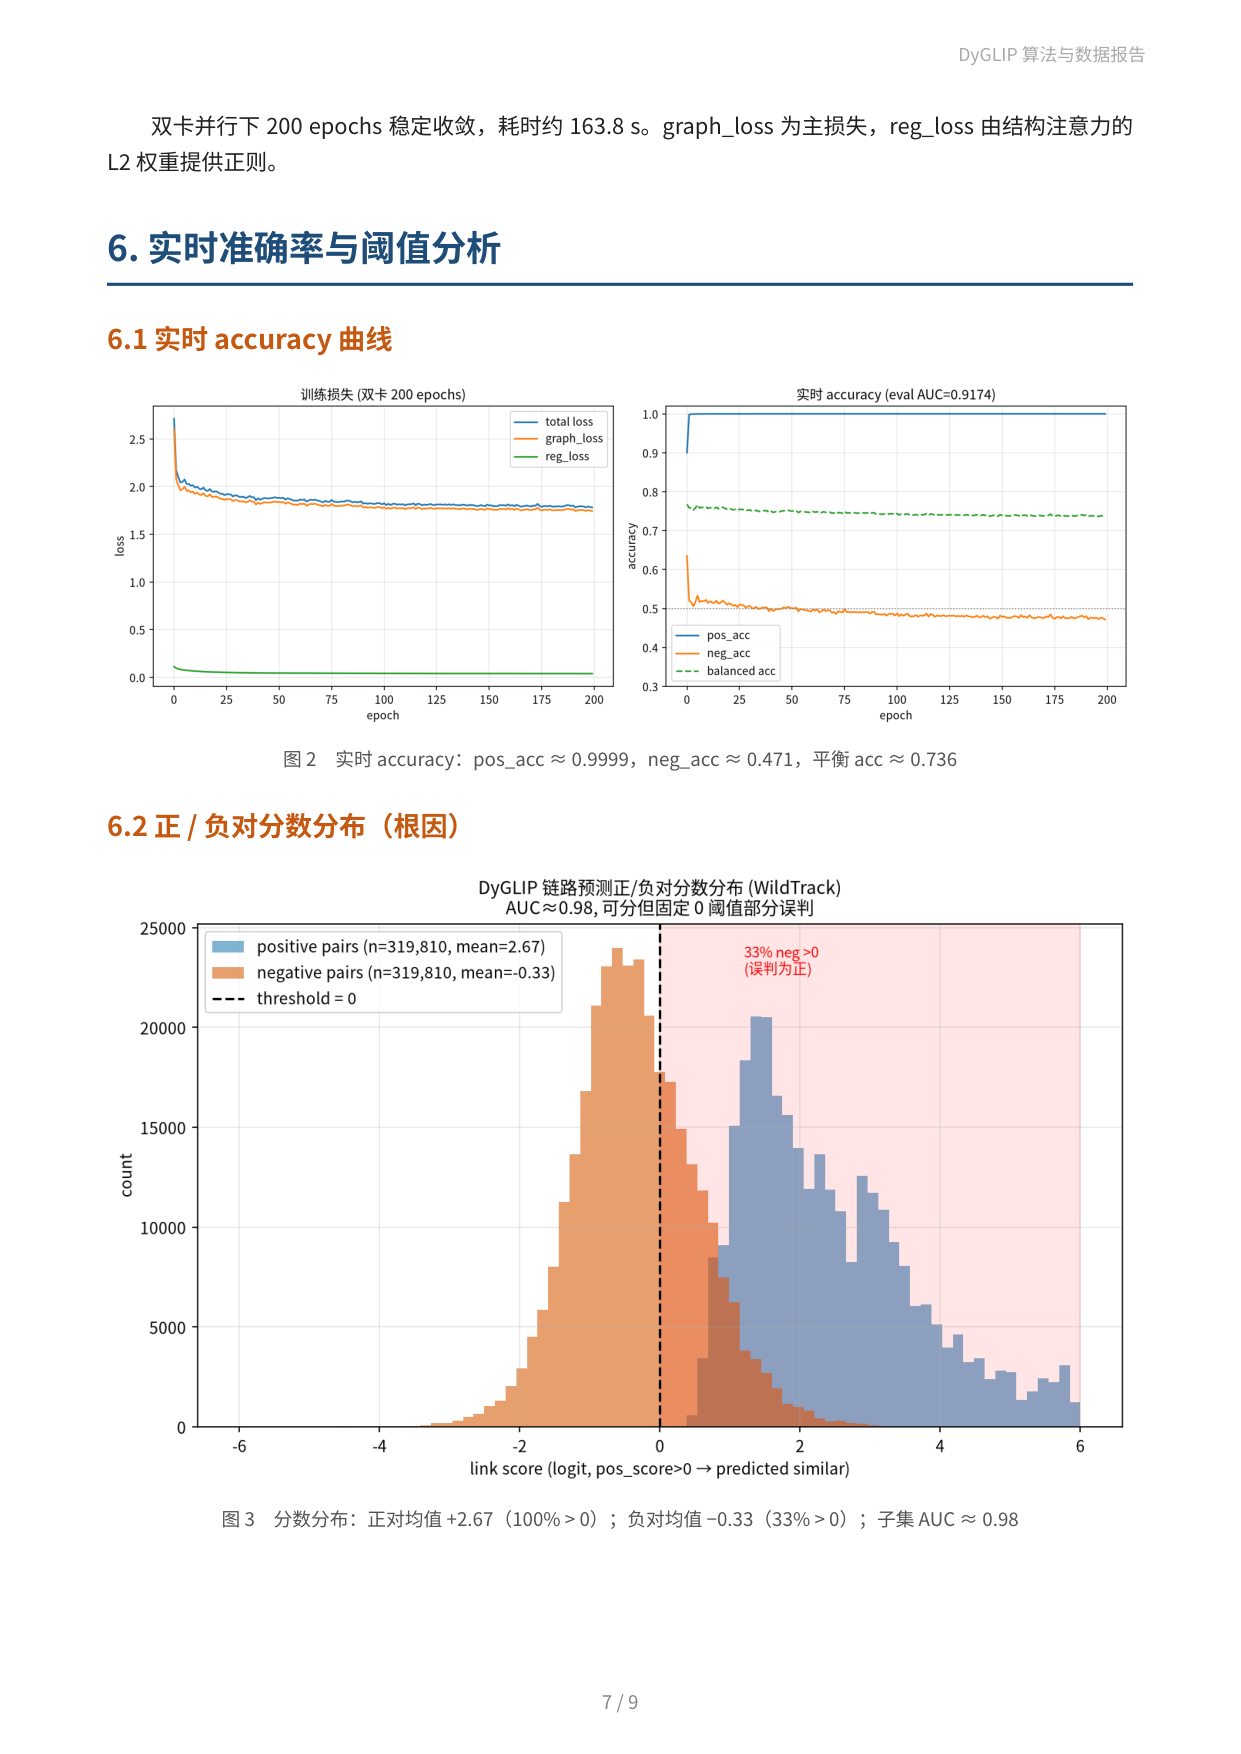
图13:复现报告 第 7 页(双卡训练收敛)
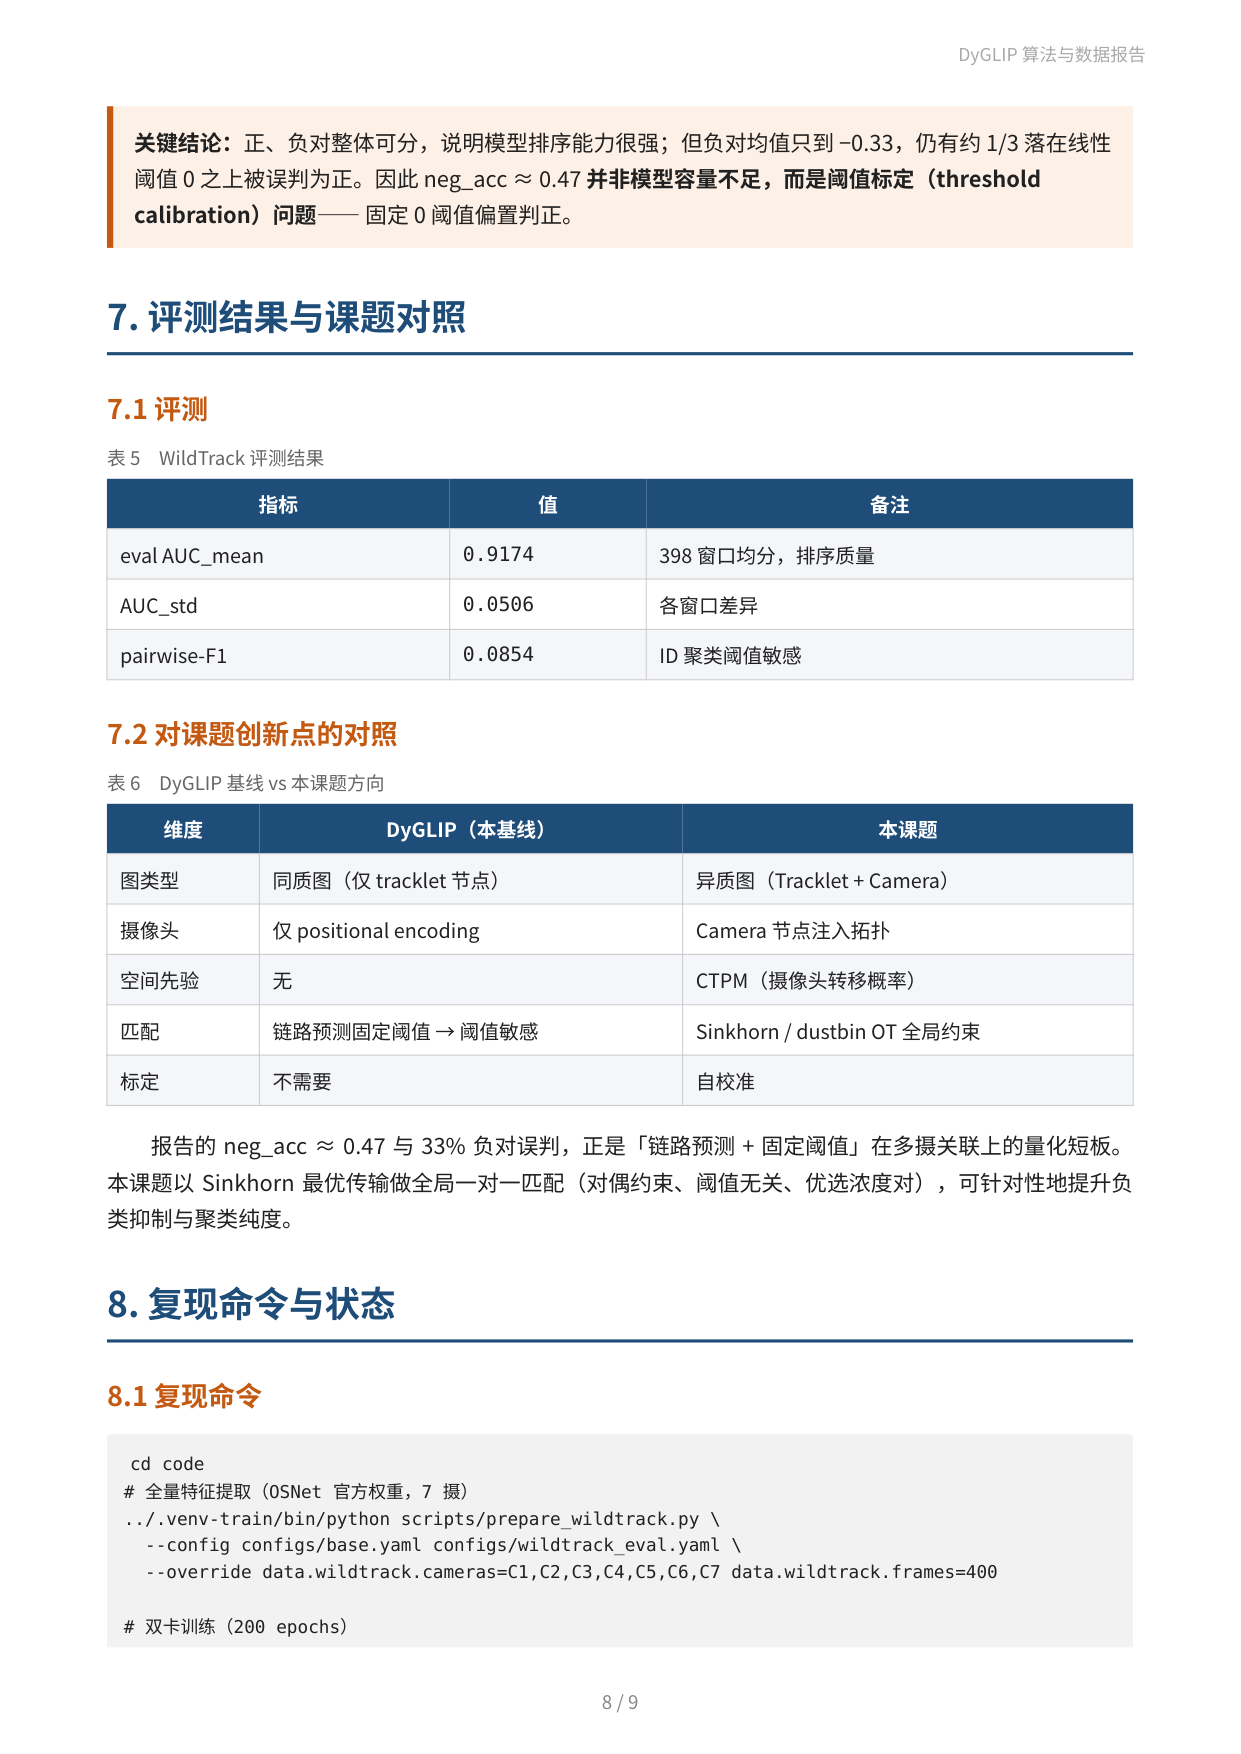
图14:复现报告 第 8 页(阈值分析)
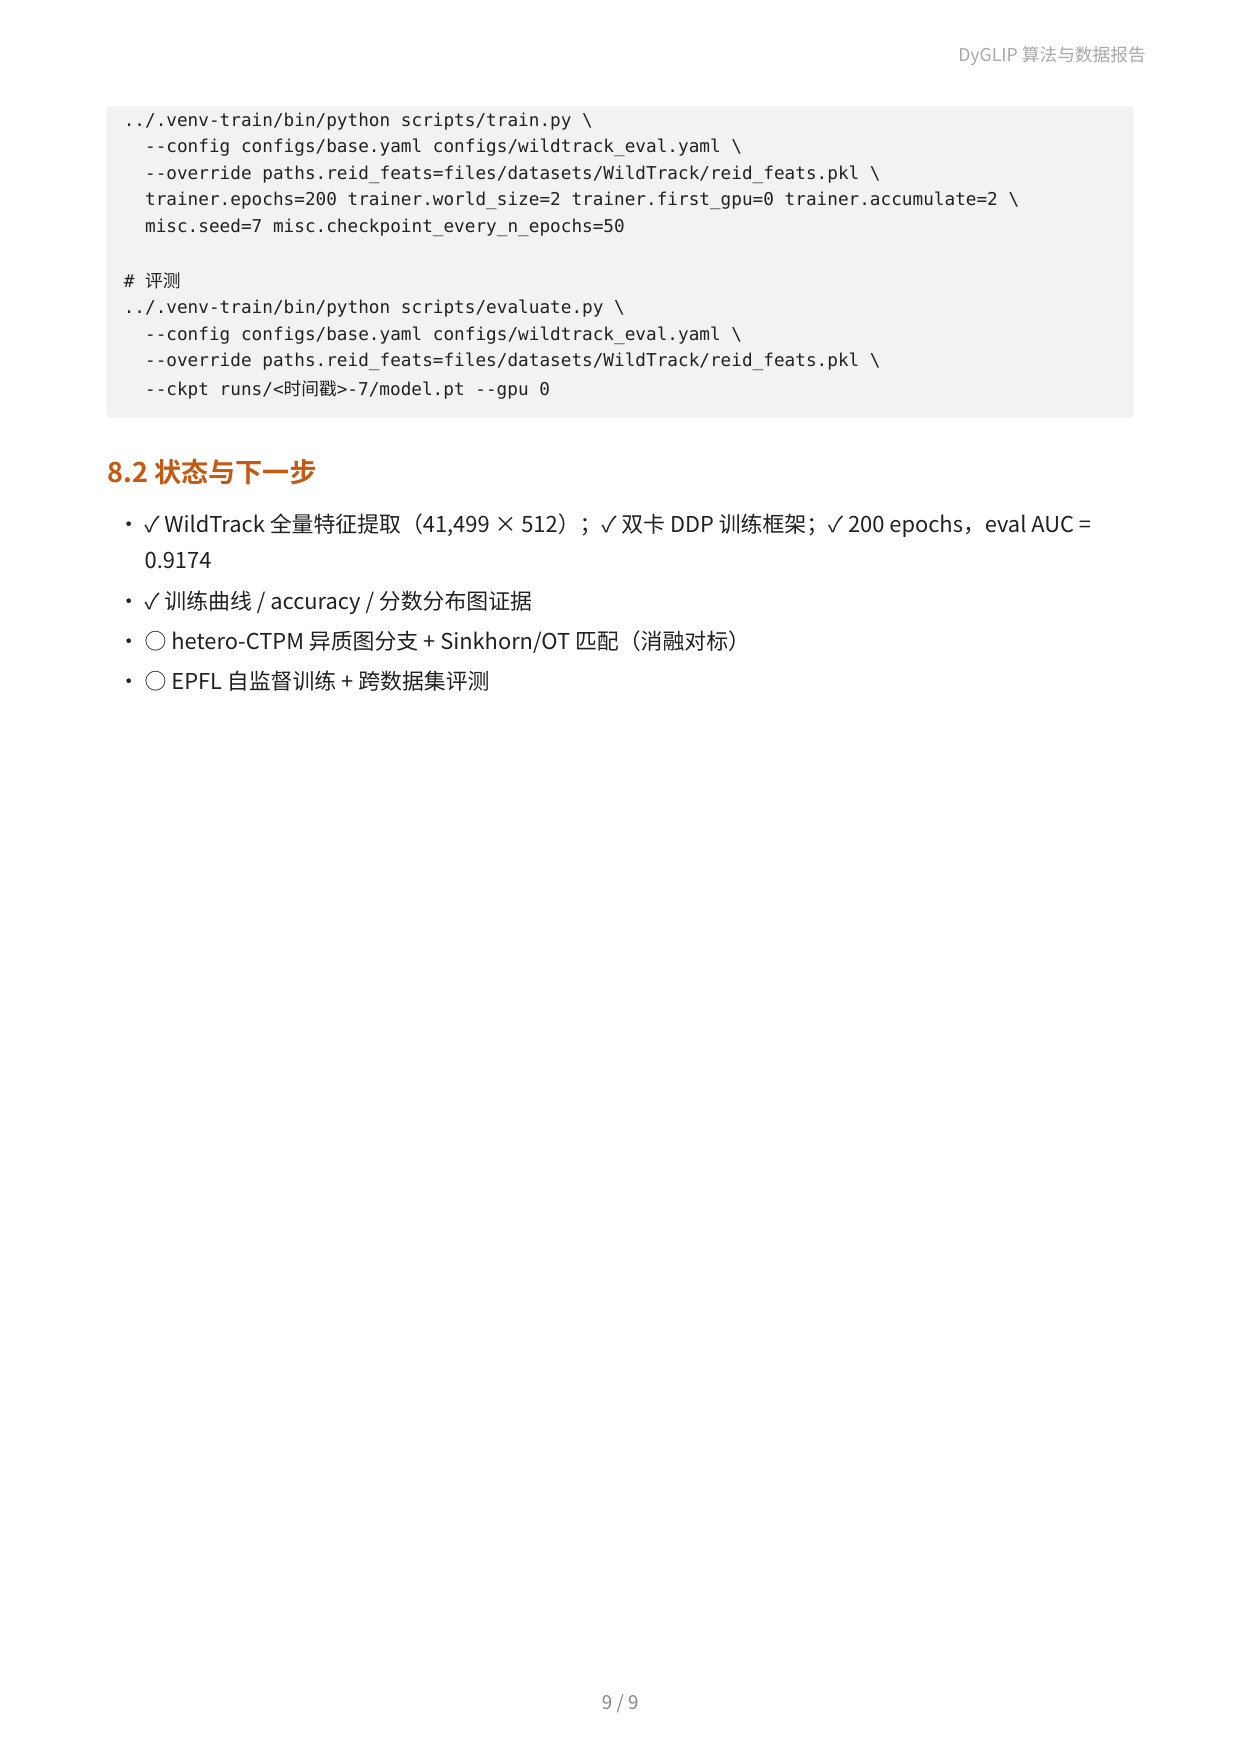
图15:复现报告 第 9 页(训练脚本与复现命令)