Transformer 是 2017 年之后几乎全部主流语言模型的骨架。它的价值不在于某个单一技巧,而在于用注意力把序列建模的三件事同时解决:任意两个位置可以直接交互、整条序列可以并行计算、位置信息以显式方式注入。本文将按自顶向下的顺序,从统一框架出发逐层推导自注意力、位置编码、残差与归一化、前馈网络与掩码,再讨论三种架构范式、训练与推理的工程要点、架构演进主线,最后给出它与图注意力之间的联系。
前言
在循环神经网络的时代,序列建模的基本单元是状态递推:模型读入第 t 个词时,把上一个时刻的状态搬过来,再算出一个新状态。这个结构有两个固有代价,一是信息从序列一端传到另一端要经过与距离成正比的若干次变换,长距离依赖容易被稀释;二是第 t 步的计算依赖第 t-1 步的结果,无法并行,训练效率被序列长度锁死。
Transformer 换掉了这个结构。它不再让信息沿着时间轴一步步传递,而是让任意两个位置直接建立连接,连接的强度由模型自己学出来。这个改变让序列建模变成了一次矩阵乘法,长度方向天然并行,代价是必须额外告诉模型谁在前谁在后,于是位置编码成为架构的必要组成。
本文的范围覆盖从组件到系统的完整链条。我们先把 Transformer 抽象成四个组件的组合,再逐个推导每个组件的数学形式与设计动机,然后看这些组件如何拼成 Encoder 与 Decoder 两种堆叠,接着讨论训练目标与推理优化,最后沿着位置编码、注意力效率、归一化与激活四条线看它是如何演化到今天的形态。文中所有公式都以最小必要假设给出,尽量保持推导链条完整。
一个常见的整体流程可以用下面的数据流概括:
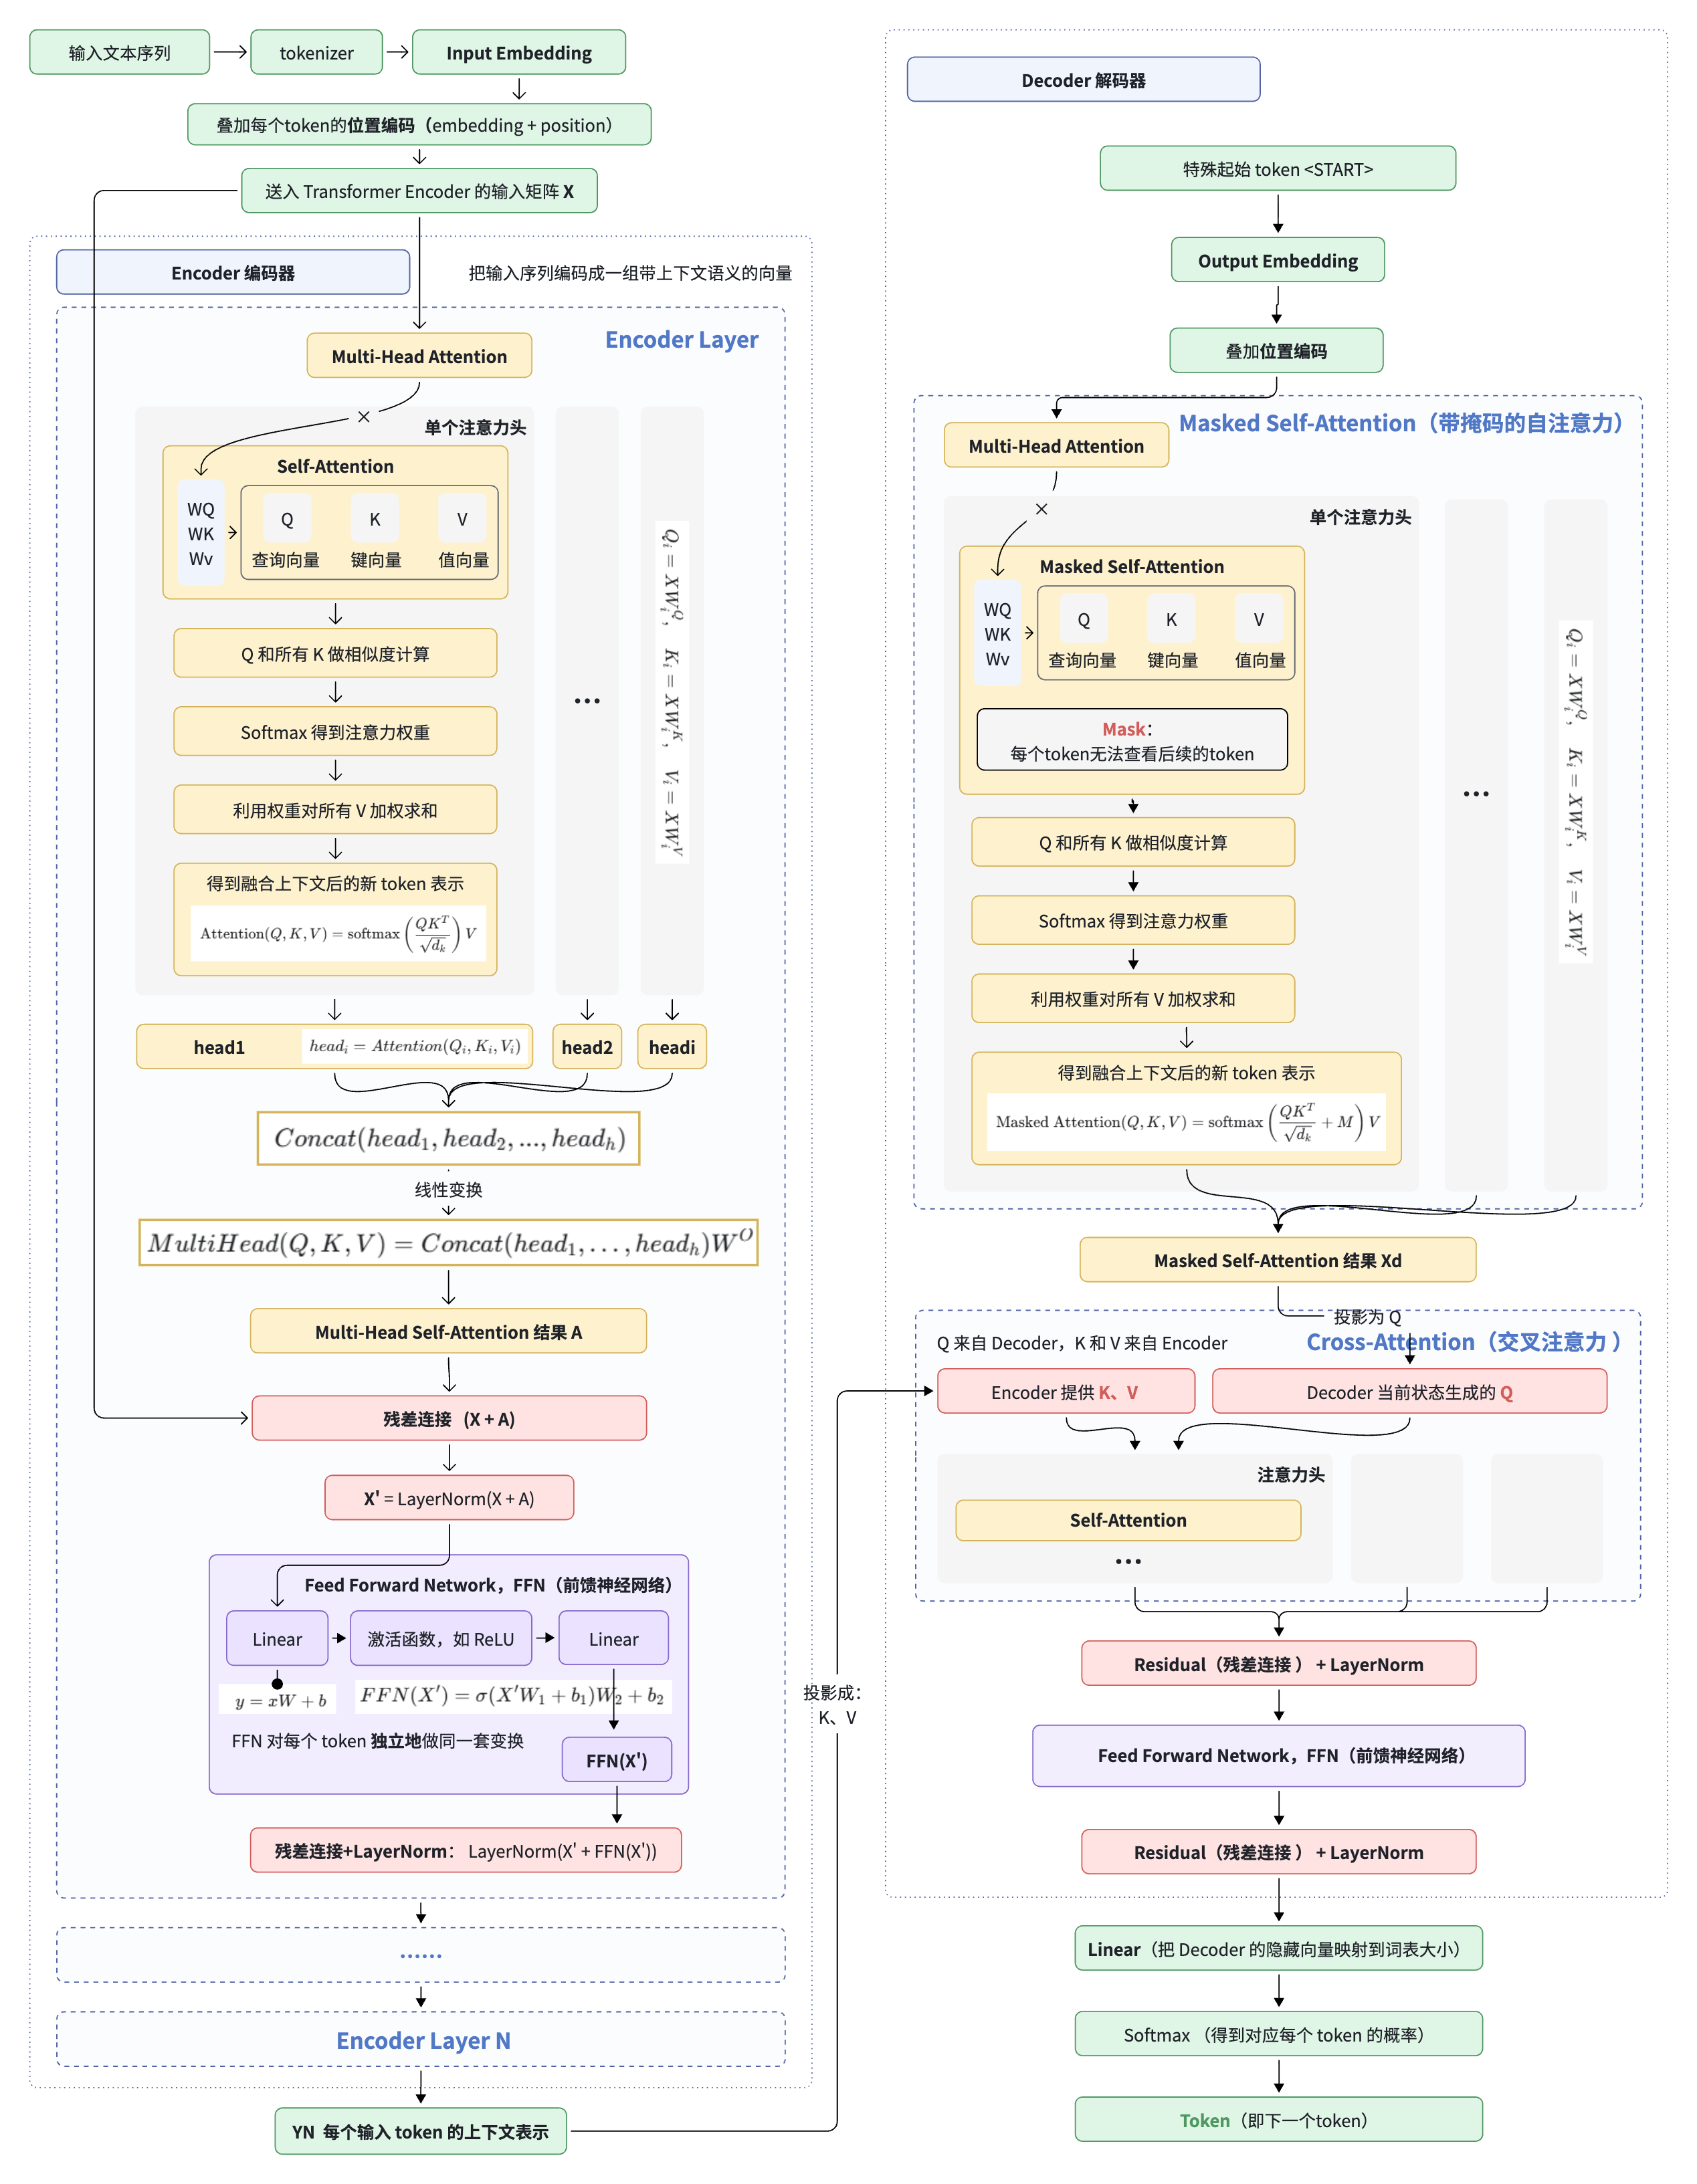
图1:Transformer 架构总览(左:Encoder,右:Decoder)
图1 给出了本文要讨论的全部结构,值得先读一遍。左侧是编码器:文本先经 tokenizer 切成子词,做词嵌入得到稠密向量,再叠加位置编码形成输入矩阵 X;X 进入 N 层 Encoder Layer,每层内部先把注意力展开到单个注意力头,依次完成 Q 与 K 的相似度计算、Softmax 归一化、对 V 加权求和,再把 h 个头的输出拼接后做一次线性变换,得到多头自注意力的结果 A;A 与原始输入做残差连接并归一化得到 X’,接着进入逐位置前馈网络,其输出再经一次残差连接与 LayerNorm 回到主干。右侧是解码器,结构与编码器基本对称,差别在于两处:自注意力被替换为带掩码的自注意力,每个 token 只能看到自己与之前的位置;自注意力之后多了一个交叉注意力子层,它的 Q 来自解码器当前状态,K 与 V 来自编码器输出。解码器最后用线性层把隐藏向量映射到词表大小,Softmax 得到下一个 token 的概率分布。
Transformer 的统一框架
我们更倾向把 Transformer 看成一个由四个组件构成的整体,而不是一堆模块的罗列:
| 组件 | 承担职责 | 在信息流中的位置 |
|---|---|---|
| 自注意力 | 在任意两个位置之间建立直接的、可学习强度的连接 | 每个 Block 的第一层 |
| 位置编码 | 把顺序与距离信息显式注入表示 | 输入端与每一层注意力的相对位置项 |
| 残差与归一化 | 保证深层堆叠可训练,稳定每层输入的分布 | 每个子层的输出端 |
| 前馈网络 | 提供逐位置的非线性变换,扩充表示容量 | 每个 Block 的第二层 |
这四个组件各自解决一个问题,缺一不可:去掉注意力就退化成逐位置的变换,去掉位置编码模型对词序不敏感,去掉残差与归一化深层网络难以收敛,去掉前馈网络模型容量会显著下降。理解这套分工之后,后面所有具体机制都可以归位到某个组件上。
前置知识:序列建模的三条约束
在进入公式之前,先把约束讲清楚。任何序列模型都要同时满足三件事:
- 长距离依赖:相隔很远的两个位置必须能高效交换信息,路径长度不能随距离增长。
- 并行计算:同一层内所有位置的计算应当互不依赖,这样才能用矩阵运算吃满硬件。
- 位置敏感:模型必须能区分相同内容的词序排列,例如 agent learns 与 learns agent。
循环结构满足第三条但不满足前两条,卷积结构部分满足第二条但长距离依赖需要堆叠多层,Transformer 用注意力加位置编码的组合同时满足三条,这也是它取代前两者的主要原因。下面从第一条开始,逐步推导注意力的具体形式。
自注意力机制
从信息检索到查询、键、值
我们需要知道,注意力机制最初是为机器翻译提出的:解码器在生成一个词时,需要在编码器的所有位置中挑出与当前生成最相关的部分。这个动作可以用检索来类比:用一个查询去比对一组键,根据匹配程度对相应的值加权求和。
Transformer 把这个动作改造成了自注意力,即查询、键、值三者都来自同一组输入向量,于是序列内部的每个位置都可以向其他所有位置检索信息。形式化地,给定输入矩阵 ,其中 是序列长度、 是模型维度,我们用三组可学习权重把它投影到三个空间:
其中 。 的每一行是一个位置的查询向量, 的每一行是它的键向量, 的每一行是它的值向量。三个投影的作用是把同一条输入表示映射到三种不同的语义角色上:查询表达我需要什么信息,键表达我能提供什么信息,值表达我实际携带的内容。注意这三个矩阵是各自独立的参数,模型在训练中会学到不同的投影方式,这是自注意力具备表达能力的第一个来源。
缩放点积注意力
有了 Q、K、V 之后,第 个位置与第 个位置的相关性用一个点积衡量:
其中 是 的第 行, 是 的第 行,分母上的 是缩放因子。把 个位置的相关性放在一起,就得到 的打分矩阵 。每一行经过 Softmax 归一化成概率分布,作为对值向量的加权系数,最后得到输出:
这里的 Softmax 逐行作用:
它的作用是把任意实数打分变成非负且和为 1 的权重,权重越大代表该位置在当前查询下越重要。输出矩阵的每一行都是值向量的加权平均,因此第 行承载的是第 个位置在读完上下文之后的表示,这正是图1 中融合上下文后的新 token 表示的含义。
缩放因子的必要性
缩放因子不是一个经验性的调参,它可以推导出来。假设查询与键的每个分量都是均值 0、方差 1 的独立随机变量,那么它们的点积是 个独立乘积之和,均值为 0,方差为:
也就是说,维度越高,点积的数值波动越大,量级大致按 增长。点积量级过大会带来一个实际问题:Softmax 的输入两端差异被放大,输出分布会退化成一个接近 one-hot 的尖峰,大部分位置的梯度趋近于 0,训练初期尤其容易陷入这种状态。除以 把方差重新拉回 1 量级,让 Softmax 工作在一个梯度健康的区间里。
多头注意力
单头注意力只能学到一种相似度度量。为了让模型在同一层里同时关注不同类型的关系,例如语法上的指代、位置上的邻近、语义上的共现,Transformer 把注意力拆成多个头并行计算。
每个头有自己的投影矩阵,在低维子空间里独立做一次缩放点积注意力:
其中 ,通常取 , 是头的数量。 个头的结果拼接后经一次输出投影整合:
这里有一个容易被忽略的细节:因为 ,多头在参数量与计算量上大致与单头等价,它换来的不是更多的计算,而是把同一份计算预算切成了 个相互独立的子空间。图1 中单个注意力头到多头拼接的过程,就是这个公式的结构化表达。多个头之间没有显式的分工约束,分工是训练中自发形成的,这也是注意力可视化研究的主要入口。
复杂度的来源
自注意力的核心是一次 的打分矩阵计算,时间与空间复杂度为:
这个平方项是 Transformer 的主要结构瓶颈,序列长度翻倍,注意力部分的计算量变为四倍;同时打分矩阵本身要占显存,长序列下往往比模型参数更吃资源。后面第七节讨论的稀疏注意力、线性注意力与 FlashAttention,都是在不改变数学定义的前提下削减这一项的实际开销。
位置编码:顺序信息如何进入模型
注意力对置换是等变的
位置编码的必要性可以用一句话说明:自注意力本身对输入的行置换是等变的。设 是一个置换矩阵,那么
这个等式意味着,如果把输入序列中两个位置的顺序对调,输出只是相应地跟着对调,模型内部的表示完全不变。换句话说,不带位置编码的注意力把序列当成一个集合来处理,它知道有哪些词、知道词与词的关系强度,但不知道谁在前谁在后。要让它对顺序敏感,就必须把位置信息注入表示,这也是图1 中输入嵌入与位置编码先相加、再送入编码器的原因。
正弦位置编码
原始论文给出的方案是用不同频率的正余弦函数构造位置向量,每个位置对应一个 维向量,其中偶数维用正弦、奇数维用余弦:
这里 是位置下标, 是维度下标。不同维度对应不同波长,波长从 一直到 按几何级数分布:低维变化快,编码精细的局部差异;高维变化慢,编码长程的位置信息。这种分布让一个位置向量同时携带多个尺度上的位置线索。
它被选中的关键理由是可以表达相对位置。对任意固定偏移 ,向量 可以由 经过一个与 无关的线性变换得到:
这个性质来自三角函数的和角公式。以某一维为例,设 ,则
也就是说,同一频率下的正弦与余弦分量通过一个二维旋转矩阵相互转换,把每个频率块的旋转矩阵拼起来就得到 。模型因此可以用线性投影学到相对位置的模式,而不必为每个绝对位置单独记忆。位置向量通常与词嵌入直接相加而非拼接,相加在实现上更省参数,也让词义与位置进入同一个表示空间。
学习式位置编码与它的外推问题
另一种常见做法是把位置编码当作可学习参数,维护一个形状为 的矩阵 ,第 行对应第 个位置,输入表示为
其中 是词嵌入矩阵。学习式编码在一些任务上表现更好,因为它可以让模型自己决定位置表示的形式,代价是位置数量被训练时的最长序列写死,超出 的位置没有参数可用,长度外推能力弱。这一问题直接催生了下面两种方案。
旋转位置编码
RoPE 的思路与前两种不同:它不再往输入里加位置向量,而是在每一层注意力计算前,按位置对查询与键施加一个旋转。以二维情形为例,位置 对应的旋转矩阵为
对查询与键分别施加位置旋转:
这样构造的巧妙之处在于内积只依赖两个位置的相对距离:
用到了旋转矩阵的正交性 与 。因此注意力打分天然带有相对位置信息,形式上位置以相对位移 的方式进入,绝对位置被消去。实际实现时把 维向量按相邻两维分块,每块用不同频率 旋转,再拼接回原维度。RoPE 的另一个好处是它不修改主干表示,只作用于注意力内部的 Q 与 K,因此可以和其他结构改进叠加。
加性偏置:ALiBi
ALiBi 选择了最直接的注入方式:不加位置向量、不旋转 Q 与 K,而是往注意力打分上按距离加一个与头相关的负偏置:
其中 是第 个头的固定斜率,距离越远惩罚越大,因此模型天然更关注邻近位置。它的优势是训练与推理的长度可以不一致:训练时见过 1k 长度,推理时直接外推到 4k 也不会出现位置参数越界的问题,因为偏置函数在整个距离区间上都有定义。
下面把四种位置编码方案放在一起对比,可以看到它们的取舍方向并不相同:
残差连接、归一化与前馈网络
残差连接与梯度通路
深度堆叠的第一个障碍是梯度传播。残差连接把子层的输出与输入相加:
对 求导得到
等式右边的单位矩阵 是关键,它保证梯度在反向传播时总有一条系数为 1 的恒等通路,即使子层内部的雅可比很小,梯度也不会在几十层堆叠下指数衰减。残差连接还带来一个结构性好处:每一层学的是对表示的增量修正,浅层负责局部模式,深层负责更长距离的组合,从这个角度看它让层与层之间的分工更清晰。
Post-LN 与 Pre-LN
归一化放在残差之前还是之后,是 Transformer 演化中最重要的一处改动。原始论文采用 Post-LN,归一化位于残差相加之后:
这种排布的问题在于主干路径上的数值要反复穿过归一化层,深层时残差的尺度会被反复压缩,训练需要精心设计的学习率预热才稳定。现代实现普遍改用 Pre-LN,把归一化移到子层内部:
此时主干是一条纯残差通路,梯度可以沿着这条路直接回传,训练稳定性明显更好,预热步数可以大幅减少甚至取消。代价是每层的输出没有被归一化,数值尺度会随深度缓慢增长,通常靠最后一层的归一化来收口。图1 中每一步注意力与 FFN 之后紧跟的 LayerNorm,就是这类排布在结构图上的体现。
LayerNorm 与 RMSNorm
归一化的作用是把每个位置的表示重新拉回稳定的数值范围,LayerNorm 的做法是对每个位置的 个维度做零均值单位方差标准化,再施加可学习的缩放与平移:
其中逐元素的均值与方差为
这里的 与 是维度上的可学习参数, 用于数值稳定。需要注意归一化的方向:它统计的是单个位置内部的维度,而不是跨样本或跨序列。这一点与 BatchNorm 相反,也是 Transformer 能处理变长序列、且训练与推理行为一致的原因。
RMSNorm 去掉了均值中心化,只保留按均方根缩放:
少一次减均值和相应的求均值操作,在相同效果下更快,现代大模型多采用这一形式。
前馈网络
Block 的第二部分是两层的逐位置前馈网络:
其中 ,,原始设定 ,中间先升维再降维,用高维空间中的非线性变换扩充表示容量。所谓逐位置,是指它对序列中的每个 token 独立地施加同一套变换,token 之间没有信息交换,图1 在 FFN 旁标注的每个 token 独立地做同一套变换就是这个意思。因此注意力负责跨位置混合信息,前馈网络负责在每个位置上做深加工,两者分工明确。
早期使用 ReLU,后来普遍换成更平滑的 GELU:
其中 是标准正态分布的累积分布函数,它在负值区域保留一个小的非零梯度,避免了 ReLU 在负半轴梯度为零的死区。近年更常见的是门控线性单元变体,用一条门控分支调制另一条分支:
其中 , 与 分别是门控与升维投影, 是降维投影。引入门控后参数量变为三组投影,实现时通常把 按 缩小,使总参数量与原始两层结构持平。这类门控 FFN 已经成为现代大模型的默认选择。
掩码与三种架构范式
填充掩码与因果掩码
真实批次里序列长度不一致,短序列要补填充位,这些位置参与注意力会引入噪声,因此需要把它们屏蔽掉,这是填充掩码。生成任务还有第二个需求:第 个位置的输出只能用前 个位置的信息,不能看到后面尚未生成的内容,这是因果掩码。两种掩码在实现上统一为往打分矩阵加一个掩码矩阵:
因果掩码的取值为
即一个下三角矩阵,右上角的 在 Softmax 之后变为概率 0,未来位置被彻底排除。用 而不是一个大负数,是为了在数值上严格保证被屏蔽位置的权重为零,避免浮点误差带来的信息泄漏。图1 右侧特别标注了这一点:每个 token 无法看到后续的 token,得到的正是带掩码的自注意力。
交叉注意力
解码器在生成时还需要读取编码器的输出,这一步由交叉注意力完成。它的形式与自注意力相同,区别只在查询与键值的来源不同:
查询来自解码器当前状态,键与值来自编码器输出,因此打分矩阵的形状是 ,不再是方阵。从信息流的角度看,交叉注意力是编码器与解码器之间唯一的连接通道,它把源序列的表示按相关性分配给解码器的每个生成位置。
三种架构范式
把注意力方向与堆叠方式组合一下,就得到了三种被广泛使用的架构范式。它们的差异可以概括为下表:
| 范式 | 注意力方向 | 训练目标 | 典型任务 |
|---|---|---|---|
| Encoder-Only | 双向,每个位置可见全部位置 | 掩码语言建模(预测被遮住的词) | 文本分类、序列标注、句向量与检索 |
| Decoder-Only | 单向,只能看到自己与之前的位置 | 自回归语言建模(预测下一个词) | 文本生成、对话、代码生成 |
| Encoder-Decoder | 编码器双向、解码器单向,外加交叉注意力 | 序列到序列的似然最大化 | 机器翻译、摘要、语音识别 |
三种范式对位置编码与掩码的要求也不同。Encoder-Only 只需要填充掩码,双向注意力让它更适合把整段文本压成一个表示;Decoder-Only 必须使用因果掩码,因为训练与推理的行为必须一致,否则训练时能看到答案、推理时看不到,性能会严重不匹配;Encoder-Decoder 两者兼有,交叉注意力负责把编码信息交给解码器。选择哪一种范式,本质上是在理解型任务与生成型任务之间做权衡,这也是当前大模型以 Decoder-Only 为绝对主流、而检索与分类类应用仍然大量使用 Encoder-Only 的原因。
训练目标与推理工程
训练目标:自回归语言建模
以 Decoder-Only 为例,训练目标是让模型学会建模整个序列的联合概率。按照概率的链式法则,序列的联合分布可以分解为逐位置条件概率的乘积:
训练时最大化这个似然等价于最小化它的负对数,再对序列长度与批量取平均,得到交叉熵损失:
其中 是全部可训练参数。这个目标与因果掩码是一对:因为掩码保证了第 个位置只能看到前 个位置,所以一次前向传播就能同时算出所有位置的预测与损失,训练在长度方向完全并行。这正是图1 中解码器必须使用带掩码自注意力的原因,若允许看到未来,训练时的条件概率就不再对应推理时的实际条件。
推理:KV 缓存
生成阶段无法并行,只能逐 token 解码。此时第 步的注意力输出为
其中 只是当前新生成位置的查询,而 与 是前 个位置的键与值。关键在于:每一步的键与值一旦算出来就不会再变,因此可以把它们缓存下来复用,也就是 KV 缓存。不缓存的话,每生成一个 token 都要把整条序列重新过一遍注意力,第 步的代价是 ;缓存之后每步只需一次查询与已缓存键值的交互,代价降为
缓存本身的显存占用与层数、头数、序列长度、每头维度成正比,长上下文场景下往往成为显存的主要组成部分。这一开销直接推动了后面要讲的 MQA、GQA 与 MLA 三种改进,它们的共同目标是压缩缓存中键与值的规模。
推理阶段的数据流与训练阶段差异很大,可以对照理解。训练时整条序列一次前向,损失在所有位置并行算出:
推理时逐 token 解码,历史键值通过缓存复用:
长序列的三条优化路线
注意力的平方复杂度有三类不同的缓解思路,它们的着力点并不相同。
第一类是稀疏注意力,限制每个位置可见的范围。典型做法是滑动窗口加少量全局位置:每个 token 只与邻近窗口内以及少数全局 token 交互,复杂度从 降到 ,其中 是窗口大小。它削减的是实际参与计算的配对数量,适合长文档类任务,代价是模型必须依赖多层堆叠与全局位置来传递远距离信息。
第二类是线性注意力,重新组织计算顺序。标准注意力无法交换乘法的结合次序,因为 Softmax 夹在中间;若把 Softmax 换成逐位置的非线性映射 ,利用结合律可以先把键与值聚合起来:
其中 的形状是 ,与序列长度无关,因此每步只需维护这个固定大小的状态,复杂度降为 。代价是表达能力的让步,Softmax 提供的尖锐选择性被替换成了较平滑的加权。
第三类是IO 感知的精确注意力,不改变数学定义,只改变计算的组织方式。打分矩阵 的显式读写是显存与带宽的主要消耗,FlashAttention 把它拆成若干块,在片上高速缓存里分块计算并用在线 Softmax 逐步累积归一化因子,避免把完整矩阵写回显存:
其中 与 分别是当前块上的最大值与指数和,用于在增量计算中保持数值稳定。三条路线分别针对配对数量、状态规模与内存带宽,工程上常按任务形态组合使用。
架构演进主线
从 2017 年到现在,Transformer 的主体骨架没有变化,改动集中在四条线上。
位置编码线
正弦编码之后,先是相对位置表示把位置信息从输入端搬到注意力内部,然后 RoPE 用旋转的方式让内积只依赖相对位移,再往后 ALiBi 用加性偏置换取了更强的外推能力。围绕长度扩展还出现了位置插值、NTK 感知的缩放、YaRN 等做法,它们的基本思路是修改 RoPE 的频率基或对位置索引做缩放,使模型在推理时能处理超出训练长度的序列。这条线回答的问题是:位置信息以什么形式进入,以及模型能否被外推到更长的上下文。
注意力效率线
多头注意力在长上下文下的 KV 缓存过大,于是出现了三种共享与压缩策略。MQA 让所有查询头共享同一组键与值:
缓存规模降到原来的 ,代价是多个头被强制关注同一份键值,表达能力受损。GQA 折中处理,把 个查询头分成若干组,每组共享一组键与值,缓存规模按分组数量下降,质量损失明显小于 MQA。
MLA 走了另一条路,不共享而是压缩:把键与值投影到一个低维潜空间,使用时再升维还原:
其中 是低维潜向量,缓存只保留它,因此缓存规模由潜维度而非原始键值维度决定。这三种方案的共同点是把压缩放在缓存侧,而查询侧保持完整,因为查询只与当前位置相关,不参与缓存。
归一化与激活线
归一化的演进是从 Post-LN 到 Pre-LN,再把 LayerNorm 简化为 RMSNorm,方向是减少主干路径上的数值干预、降低计算开销。激活的演进是从 ReLU 到 GELU,再到带门控的 SwiGLU 家族,方向是在相同参数量预算下提高非线性表达效率。这两条改动都不改变架构的拓扑,属于同一结构下的实现级优化,但它们对训练稳定性与最终质量的影响很大,现代模型的默认配置基本都落在 Pre-LN 加 RMSNorm 加门控 FFN 这个组合上。
稀疏化线
混合专家把前馈网络拆成多组专家,每次只激活其中一小部分:
其中 是第 个专家网络, 是路由权重,TopK 表示只保留打分最高的 K 个专家。这样模型总参数量可以大幅增长,而每个 token 的实际计算量只与激活的专家数量相关,也就是把总参数与激活参数分离开来。这条线解决的是容量与计算成本的解耦问题,代价是引入了负载均衡、专家通信与路由稳定性等新的工程议题。
把四条线放在一起,可以看到它们各自回答的问题不同:
从序列注意力到图注意力
最后回到前言里提出的统一视角。注意力的定义只依赖两件事:如何为两个位置算相似度,以及如何按相似度聚合值。这个定义并不要求位置排成一条序列,只要能为任意两个节点定义打分,就可以在图上做同一件事。图注意力网络正是这样一次迁移。
设节点特征为 ,先用一个共享的线性变换把特征投影到注意力空间,再对每一对相邻节点计算打分并归一化:
节点的输出是邻居特征的加权聚合:
其中 是节点 的邻居集合, 是打分用的参数向量, 表示拼接。与序列注意力的差别有三处:打分函数从点积换成了带非线性的加性形式,键与值不再来自同一组输入而是来自邻居节点,归一化范围从整条序列缩小到邻域。前两处是形式差异,第三处是结构差异,它让计算复杂度与图的稀疏度而不是节点数的平方相关。
图注意力存在一个容易被忽略的缺陷。若把打分写成 ,由于非线性被放在打分的外侧,查询与键之间只经过一次普通的线性变换,因此注意力权重的相对排序与查询节点无关,同一个目标节点在所有权重下得到的排序是一致的,这被称为静态注意力。修正方式是把非线性移入打分内部:
此时打分对查询与键的交互是非线性的,排序会随查询变化,也就是动态注意力。这一改动形式极小,但它把图注意力从一种固定的加权平均变成了真正的条件化聚合,这一点与序列注意力中缩放点积的自适应性是同源的。
统一视角下,序列注意力、带偏置的位置编码与图注意力可以写成同一个式子:
其中偏置项 的来源决定了模型的先验。在正弦编码与学习式编码里,位置信息被并入了表示本身,相当于 由编码间接给出;在 ALiBi 里它是距离的线性函数 ;在图注意力里它是节点对的关系特征或边类型;在异质图里它还可以是节点类型的先验。我在多摄像头多目标跟踪的研究中就用到了这一形式:把摄像头与轨迹构造成二分异质图,用带对数偏置的 GATv2 计算匹配分数,此时的偏置项承载的是摄像头之间的空间邻接关系与时间间隔先验,与 RoPE 承载相对位移先验在结构上完全一致。
参考
[1] Vaswani A, et al., Attention Is All You Need. NeurIPS, 2017.
[2] Bahdanau D, Cho K, Bengio Y, Neural Machine Translation by Jointly Learning to Align and Translate. ICLR, 2015.
[3] Gehring J, et al., Convolutional Sequence to Sequence Learning. ICML, 2017.
[4] Devlin J, et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL, 2019.
[5] Radford A, et al., Language Models are Unsupervised Multitask Learners. OpenAI Technical Report, 2019.
[6] Brown T, et al., Language Models are Few-Shot Learners. NeurIPS, 2020.
[7] Shaw P, Uszkoreit J, Vaswani A, Self-Attention with Relative Position Representations. NAACL, 2018.
[8] Su J, et al., RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing, 2024.
[9] Press O, Smith N, Lewis M, Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation. ICLR, 2022.
[10] Chen S, et al., Extending Context Window of Large Language Models via Positional Interpolation. arXiv, 2023.
[11] Peng B, et al., YaRN: Efficient Context Window Extension of Large Language Models. ICLR, 2024.
[12] Shazeer N, Fast Transformer Decoding: One Write-Head is All You Need. arXiv, 2019.
[13] Ainslie J, et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. EMNLP, 2023.
[14] DeepSeek-AI, DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv, 2024.
[15] Ba J, Kiros J, Hinton G, Layer Normalization. arXiv, 2016.
[16] Zhang B, Sennrich R, Root Mean Square Layer Normalization. NeurIPS, 2019.
[17] Xiong R, et al., On Layer Normalization in the Transformer Architecture. ICML, 2020.
[18] Hendrycks D, Gimpel K, Gaussian Error Linear Units (GELU). arXiv, 2016.
[19] Shazeer N, GLU Variants Improve Transformer. arXiv, 2020.
[20] Dao T, et al., FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS, 2022.
[21] Beltagy I, Peters M, Cohan A, Longformer: The Long-Document Transformer. arXiv, 2020.
[22] Katharopoulos A, et al., Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention. ICML, 2020.
[23] Fedus W, Zoph B, Shazeer N, Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. JMLR, 2022.
[24] Veličković P, et al., Graph Attention Networks. ICLR, 2018.
[25] Brody S, Alon U, Yahav E, How Attentive are Graph Attention Networks? ICLR, 2022.
[26] Alammar J, The Illustrated Transformer. 2018.
[27] Rush A, et al., The Annotated Transformer. Harvard NLP.
[28] Weng L, The Transformer Family Version 2.0. Lilian Weng Blog, 2023.